

Verificación frente a pruebas de restauración
Las pruebas de backup son el proceso de confirmar que los datos protegidos pueden recuperarse, restaurarse, validarse y devolver a un estado utilizable. Las pruebas abarcan desde una verificación de sumas de control hasta un ejercicio completo de recuperación ante desastres, y cada nivel responde a una pregunta distinta.
CISA recomienda mantener copias de seguridad offline y cifradas, y probar periódicamente su disponibilidad e integridad en un escenario de recuperación ante desastres.
Una comprobación de checksums no puede demostrar que una aplicación arrancará, y una restauración de archivos exitosa no demuestra que una base de datos sea coherente. Ni siquiera una máquina virtual iniciada garantiza que los usuarios puedan acceder al servicio. Cada nivel proporciona una evidencia más sólida que el anterior, por lo que se necesitan tanto la verificación automatizada como las pruebas reales de restauración.
Por qué trabajos de backup exitosos pueden fallar durante la recuperación
Un backup puede mostrar un estado en verde mientras que la recuperación sigue siendo imposible o incompleta. Entre las causas habituales se incluyen:
Las pruebas descubren estas deficiencias antes de que un incidente real las exponga bajo presión.
La escala de pruebas de backup
Un programa útil avanza desde comprobaciones automatizadas simples hasta ejercicios de recuperación completos.
Monitorizar los trabajos de backup
Revisa si los trabajos se completaron y qué advertencias generaron: estado, tiempos, cambios de tamaño, programaciones omitidas, capacidad y estado de verificación. Un registro de trabajo limpio indica que la plataforma intentó la tarea sin registrar un error fatal conocido. No demuestra que los datos estén completos, limpios o sean restaurables.
Verificar la integridad del backup
Ejecuta comprobaciones de integridad automatizadas en los puntos de recuperación almacenados. Proxmox Backup Server admite trabajos de verificación programados y recomienda reverificar todos los backups al menos una vez al mes, ya que los datos previamente válidos pueden degradarse con el tiempo. El fallo en una verificación de checksums puede ayudar a detectar modificaciones inesperadas, como el cifrado por ransomware. La verificación es un control adicional y no basta por sí sola como protección frente a ransomware.
Restaurar archivos de muestra
Restaura una selección representativa de archivos (pequeños y grandes, de cambios recientes y más antiguos, cifrados y con permisos específicos) en una ubicación independiente. Confirma que cada archivo se abre, que el contenido y la versión son correctos y que los permisos y las marcas temporales son adecuados.
Restaurar un sistema completo
Restaura una máquina virtual, contenedor, servidor o equipo completo en un entorno aislado. Comprueba que el sistema operativo arranca, los discos se conectan, las interfaces de red se detectan, los servicios se inician y las cuentas necesarias están presentes.
Validar la aplicación
Prueba desde la perspectiva del usuario y de las dependencias: inicia la base de datos, ejecuta comprobaciones de coherencia, conecta la aplicación, autentica a un usuario de prueba y realiza lecturas y escrituras con datos de prueba. Que el servidor haya arrancado correctamente no constituye una validación completa de la aplicación.
Probar la recuperación desde la copia externa
Ejecuta una recuperación sin utilizar el repositorio principal de backups. Confirma que puedes obtener credenciales, claves de cifrado, medios, software de backup, acceso a la red y la aprobación necesaria para comenzar. Un backup externo al que nadie puede acceder durante un incidente no constituye una vía de recuperación real.
Realizar un simulacro de recuperación ante desastres
Asume que una parte significativa de la infraestructura habitual no está disponible: la pérdida del clúster o del servidor de backup, un ataque de ransomware que afecte a producción y a los backups locales, o la inaccesibilidad de la sede principal. Esto pone a prueba la tecnología, las personas, los procesos, la toma de decisiones, la comunicación y los tiempos de forma conjunta.
Las directrices de AWS recomiendan definir objetivos claros de RPO y RTO, documentar problemas y lecciones aprendidas, y actualizar la estrategia de recuperación a partir de los resultados de las pruebas.
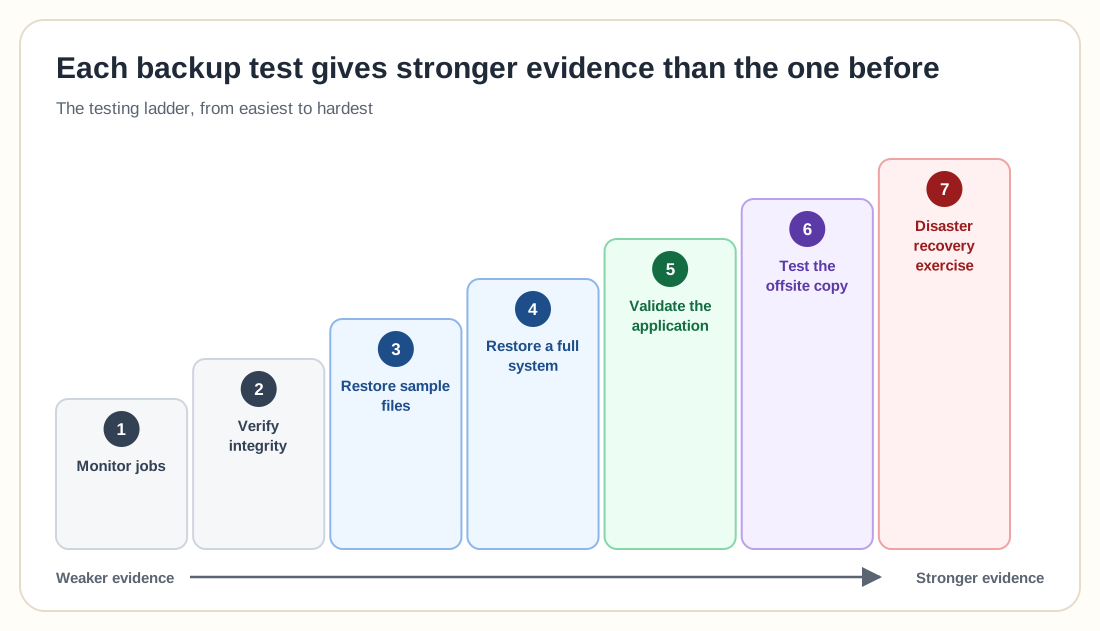
Tipos de pruebas de backup y recuperación ante desastres
Frecuencia de las pruebas
Un calendario de partida práctico. Las cargas de trabajo críticas pueden requerir pruebas más frecuentes.
Pruebas de backup en Proxmox
Un programa práctico para Proxmox combina la revisión diaria de trabajos, restauraciones de archivos y verificaciones semanales, restauraciones mensuales completas de VM con confirmación de arranque, pruebas trimestrales de aplicaciones multi-VM y un escenario anual que contemple la pérdida de un nodo, del clúster o del servidor principal de PBS. La verificación protege frente a ciertas formas de corrupción de datos almacenados, pero solo una restauración real confirma que la máquina virtual, la aplicación, las credenciales y las dependencias funcionan de forma conjunta.
Pruebas según la carga de trabajo
Bases de datos
Prueba la restauración de backups completos, cadenas incrementales o diferenciales, restauración de registros de transacciones, recuperación en un punto en el tiempo (PITR), coherencia de la base de datos y conectividad con las aplicaciones. Registra el punto exacto en el tiempo recuperado. Una prueba de base de datos debe demostrar tanto la capacidad de recuperación como la integridad de los datos.
Servidores de archivos
Prueba más que un documento reciente. Incluye estructuras de carpetas profundas, permisos y listas de control de acceso (ACL), versiones anteriores, carpetas eliminadas y archivos pertenecientes a periodos de retención más antiguos. Solicita a un usuario o responsable de datos que valide contenido recuperado representativo siempre que resulte viable.
Kubernetes
Prueba la recuperación de volúmenes persistentes, definiciones de recursos del clúster, CRD, Secrets, ConfigMaps, operadores, configuración de ingress y dependencias externas. Confirma que la aplicación recuperada funciona en el clúster de destino; que exista un snapshot del volumen no resulta suficiente.
Datos de SaaS
Confirma la restauración a nivel de elemento, restauración de carpetas o buzones, permisos, historial de versiones y metadatos, así como si la plataforma restaura directamente en su lugar, en una ubicación alternativa o mediante exportación y reimportación.
Recuperación frente a ransomware
Asume que el punto de recuperación más reciente puede no ser seguro. Pon a prueba la capacidad para identificar un punto presumiblemente limpio, acceder a una copia offline o inmutable, construir un entorno de recuperación no comprometido, restablecer credenciales con privilegios y reconectar servicios de manera gradual.
Medición de RPO y RTO, y definición de criterios de éxito
Para evaluar el RPO, registra la hora de simulación del incidente, la hora del último punto de recuperación utilizable y compara la diferencia real con el objetivo.
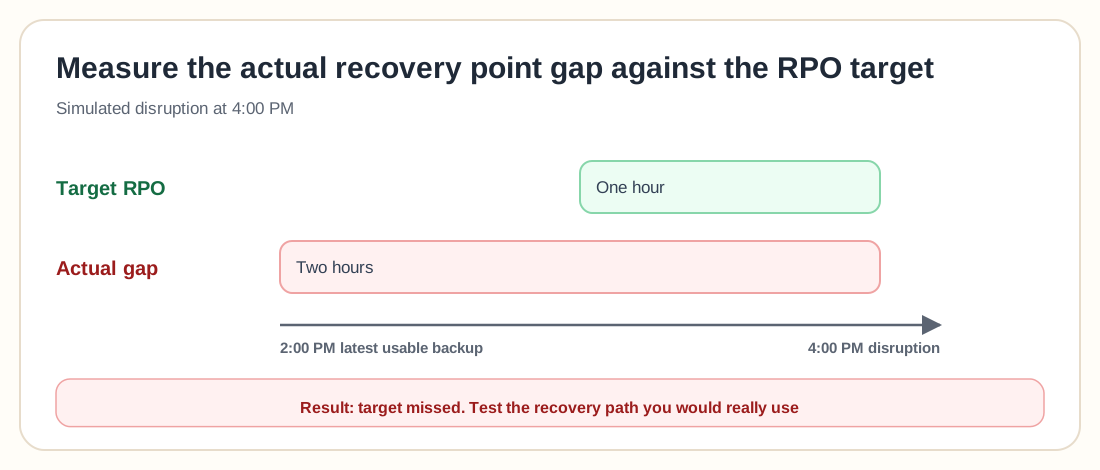
Un backup puede ejecutarse cada hora mientras el último punto de recuperación verificado en la ubicación externa tiene dos horas de antigüedad, por lo que es necesario probar la ruta de recuperación que realmente se emplearía durante un incidente. Para el RTO, inicia el cronómetro en un punto de referencia uniforme (interrupción, declaración o autorización) y registra el tiempo empleado en detección, escalado, decisión, acceso a credenciales, preparación de infraestructura, restauración, validación y comunicación.
Definir criterios de aprobado y suspenso con antelación
No decidas si una prueba tuvo éxito tras observar el resultado. Una prueba de restauración de máquina virtual puede considerarse aprobada únicamente cuando el punto de recuperación se restaura, la VM arranca, los servicios necesarios se inician, el aislamiento de red se mantiene, un usuario de prueba puede iniciar sesión y la recuperación concluye dentro del RTO objetivo. Documenta las recuperaciones parciales como parciales en lugar de redondearlas al éxito.
Qué evidencias deben registrarse
Las evidencias deben guardarse en un lugar que permanezca accesible durante un incidente real.
Errores frecuentes en las pruebas de backup
Un panel con indicadores en verde no demuestra la capacidad de recuperación. Añade restauraciones de archivos, sistemas y aplicaciones.
El punto de recuperación más reciente puede contener corrupción o ransomware. Prueba puntos con mayor tiempo de retención.
Una restauración de prueba no planificada puede sobrescribir datos actuales o provocar conflictos de red e identidades. Utiliza siempre un destino aislado.
El contenido recuperado puede ser inútil si la propiedad y los controles de acceso son incorrectos. Valida metadatos y permisos.
Un sistema operativo iniciado no equivale a un servicio de negocio recuperado. Prueba las funciones reales de la aplicación.
Las pruebas locales no demuestran que la recuperación funcione tras la pérdida de la sede. Prueba la copia remota o protegida.
Un ataque real puede comprometer las credenciales de producción ordinarias. Prueba el acceso utilizando credenciales de recuperación protegidas.
Sin medición no se puede demostrar el RTO. Registra cada fase de la recuperación.
Una prueba fallida resulta muy valiosa si conduce a una acción correctiva. Haz seguimiento de la deficiencia y repite la prueba.
No dejes disponibles todos los sistemas de producción, contraseñas, especialistas y repositorios si el escenario presupone que se han perdido.
Lista de comprobación de pruebas de backup
0 / 24Preguntas frecuentes
Las pruebas de backup confirman que los datos protegidos pueden ser accedidos, restaurados, validados y devueltos a un estado utilizable.
No. La verificación comprueba la integridad de los datos almacenados. Una prueba de restauración recupera los datos y demuestra que el proceso de recuperación funciona.
Revisa los trabajos fallidos de forma continua o diaria, verifica las copias periódicamente, restaura archivos de muestra mensualmente, prueba sistemas completos de forma periódica y realiza simulacros de recuperación ante desastres según la importancia de la carga de trabajo.
No. Un trabajo completado con éxito no demuestra que se hayan incluido todos los datos necesarios, que la aplicación sea coherente o que la recuperación pueda cumplir con el RPO y el RTO.
Debe identificar el punto de recuperación, el destino de restauración, los criterios de validación, el RPO y RTO objetivo, las dependencias, las personas responsables y el resultado de aprobado o suspenso.
No todos los puntos de recuperación necesitan una restauración completa del sistema. Utiliza la verificación automatizada a gran escala y selecciona puntos de recuperación representativos para pruebas de archivos, sistemas, aplicaciones y copias externas.
Restáuralo en una red aislada o en una ubicación alternativa. Modifica las identidades de red en conflicto y evita que los servicios recuperados se comuniquen de forma inesperada con el entorno de producción.
Es un proceso programado que restaura o inicia una carga de trabajo protegida en un entorno aislado y comprueba condiciones predefinidas como el estado de arranque, la disponibilidad del servicio o la salud de la aplicación.
No. Solo confirma que los datos almacenados coinciden con la información de integridad registrada. Sigue siendo necesaria una prueba real de restauración y arranque de la VM.
Utiliza trabajos de verificación de PBS, restaura archivos, restaura máquinas virtuales o contenedores completos en entornos aislados, valida las aplicaciones invitadas, prueba copias remotas y compara la recuperación medida con el RPO y el RTO.
Utiliza un escenario controlado donde los sistemas de producción, las credenciales habituales o los backups locales se consideren no disponibles. Recupera un punto limpio desde almacenamiento protegido sin utilizar malware real.
Documenta la causa, asigna una acción correctiva, actualiza el proceso de recuperación y programa una nueva prueba. El fallo debe permanecer abierto hasta que la ruta de recuperación se demuestre con éxito.
Un backup se gana la confianza cuando se restaura
Los backups son fundamentales porque proporcionan un camino de regreso a un sistema operativo. Las pruebas demuestran si ese camino está despejado. Comienza con comprobaciones automáticas de integridad y restauraciones sencillas de archivos, para avanzar después hacia la restauración de sistemas completos, la validación de aplicaciones, la recuperación desde copias externas y la ejecución de simulacros realistas de recuperación ante desastres. Mide el RPO y el RTO reales, registra los fallos con total transparencia, corrige el proceso y vuelve a probar.
La mejor estrategia de backup es la que ha demostrado repetidamente que restaura los datos adecuados en un servicio utilizable y dentro del tiempo establecido, al margen de lo que indiquen los informes de sus trabajos.