

RPO y RTO de un vistazo
El Objetivo de Punto de Recuperación (RPO) y el Objetivo de Tiempo de Recuperación (RTO) convierten la pregunta de «cuánto podemos perder» en objetivos medibles. El RPO mide la pérdida de datos aceptable en el tiempo. El RTO mide el tiempo de inactividad aceptable.
AWS define el RPO como el tiempo máximo aceptable desde el último punto de datos recuperable, y el RTO como el retraso máximo aceptable entre la interrupción del servicio y su restauración.
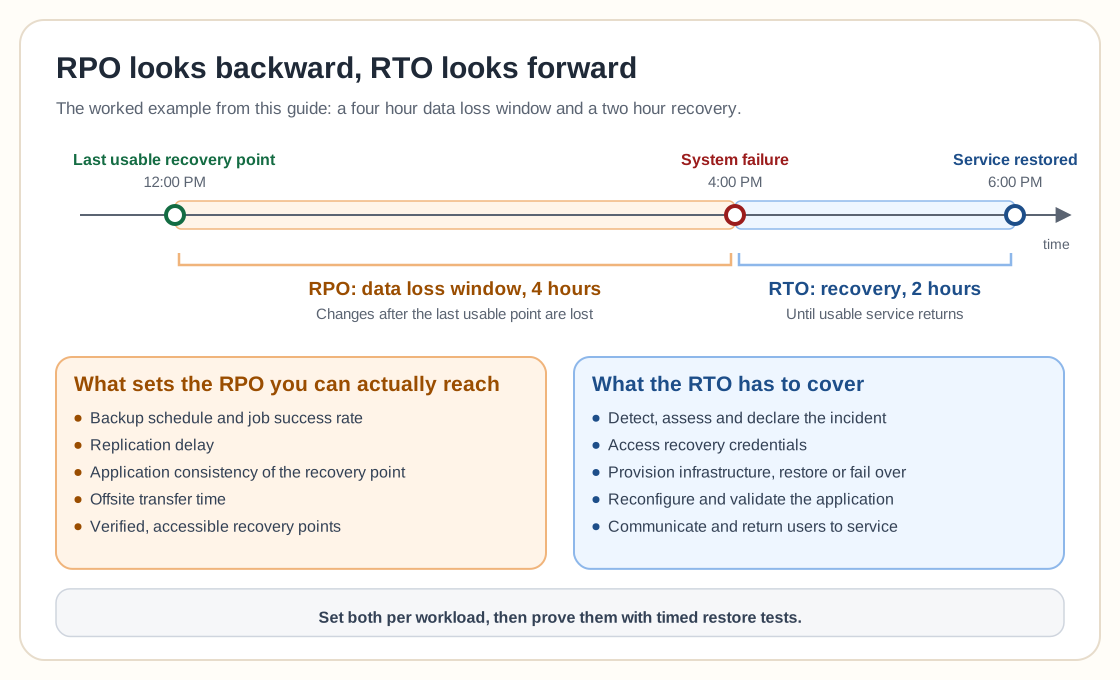
Mira hacia atrás desde el momento de la interrupción. Es el margen máximo aceptable entre el punto de recuperación utilizable más reciente y el incidente.
Mira hacia adelante desde el momento de la interrupción. Es el retraso máximo aceptable antes de que el servicio vuelva a ser utilizable.
Un ejemplo práctico
La ventana real de pérdida de datos es de cuatro horas; la duración real de la recuperación es de dos horas. Si el RPO objetivo era de cuatro horas y el RTO objetivo era de dos horas, ambos objetivos se cumplieron. Si el servicio se hubiera restablecido a las 8:00 PM, el RTO se habría incumplido aunque el RPO siguiera dentro del margen previsto.
Estos objetivos deben definirse por carga de trabajo. Un sitio web público, una base de datos contable, un servicio de identidad y un servidor de desarrollo rara vez requieren el mismo objetivo de recuperación.
Lo que el RPO y el RTO no son
El RPO no es simplemente la frecuencia de backup
La frecuencia de las copias de seguridad influye notablemente en el RPO, pero no son lo mismo. Un backup cada hora no garantiza un RPO de una hora si el trabajo falla, el punto de recuperación está dañado, la replicación se retrasa, la aplicación se capturó de forma incoherente o el repositorio no está disponible. Una programación horaria hace posible un RPO de una hora, pero son los puntos de recuperación verificados y accesibles los que hacen creíble ese objetivo.
El RTO no es simplemente la velocidad de restauración
La velocidad de restauración es solo una parte del RTO. El tiempo total de recuperación puede incluir detectar el incidente, escalar el problema, tomar la decisión de recuperar, acceder a los sistemas de backup, aprovisionar infraestructura de sustitución, restaurar datos, iniciar servicios, reconfigurar redes y DNS, validar aplicaciones, reconectar usuarios y comunicar el estado. Una máquina virtual puede restaurarse en 30 minutos mientras la aplicación completa tarda seis horas en volver a ser utilizable, por lo que el RTO debe cubrir todo el proceso; la copia de datos es solo una parte.
Ejemplos de RPO y RTO
Un backup diario puede ser suficiente para archivos personales donde perder un día de cambios resulte tolerable. En cambio, cumplir un RPO de 15 minutos en una tienda online puede requerir protección de registros de base de datos, replicación, automatización, infraestructura en espera y failover probado. Las copias de seguridad nocturnas por sí solas no cumplirían ese objetivo.
RPO y RTO por nivel de carga de trabajo
Un modelo de clasificación sencillo evita tener que diseñar cada carga de trabajo desde cero. Son ejemplos de planificación, no normas universales.
La guía de planificación de contingencias del NIST recomienda evaluar sistemas y operaciones para determinar requisitos y prioridades de recuperación en lugar de tratar todos los sistemas por igual.
Cómo definir un RPO
Medir la tasa de cambio
Determina cuántos datos crea o modifica la carga de trabajo en 15 minutos, una hora, cuatro horas, una jornada laboral y una semana. Un RPO de cuatro horas significa algo muy distinto para un servidor de archivos estático que para una base de datos transaccional.
Calcular el coste de reconstrucción
Pregúntate si los datos perdidos pueden recrearse volviendo a introducir facturas, reprocesando transacciones o resincronizando sistemas de origen. Si la reconstrucción resulta lenta, costosa o imposible, el RPO debe ser más corto.
Tener en cuenta la coherencia
El backup más reciente no siempre es el mejor punto de recuperación. Una base de datos o una aplicación multiservicio puede requerir un punto coordinado y coherente a nivel de aplicación que sea más antiguo que el snapshot individual de archivo o volumen más reciente.
Contemplar el retraso en la detección
La corrupción y el ransomware pueden pasar desapercibidos durante días o semanas. El RPO describe la pérdida aceptable de datos recientes, mientras que la retención determina hasta qué punto en el pasado siguen disponibles los puntos de recuperación. Necesitas ambos.
Validar el objetivo
Compara el RPO seleccionado con la programación real de backups, la tasa de éxito de los trabajos, el retraso de replicación, el tiempo de verificación, la coherencia de las aplicaciones y la transferencia a otra ubicación. No publiques un RPO que el sistema actual nunca haya demostrado en la práctica.
Cómo definir un RTO
Identificar el estado de recuperación utilizable
Define qué significa «restaurado»: archivos accesibles, máquina virtual arrancada, base de datos aceptando conexiones, aplicación superando comprobaciones de salud, usuarios capaces de iniciar sesión. Sin un estado de recuperación acordado, nadie puede determinar si se ha cumplido el RTO.
Mapear cada paso de la recuperación
Documenta la secuencia completa: detectar, evaluar, declarar, acceder a credenciales de recuperación, aprovisionar infraestructura, restaurar o conmutar por failover, reconfigurar, validar, comunicar y devolver al servicio.
Asignar responsabilidades
Registra quién ejecuta cada tarea y quién tiene autorización para aprobar la recuperación. Un proceso técnicamente rápido puede incumplir su RTO porque nadie tiene autoridad para empezar.
Medir las dependencias
La aplicación puede depender de DNS, identidad, redes, certificados, bases de datos, almacenamiento, secretos, API externas y licencias. El RTO efectivo de la aplicación no puede ser inferior al de la dependencia más lenta requerida.
Probar la recuperación completa
Ejecuta un ejercicio de recuperación cronometrado y registra el tiempo necesario para detectar, decidir, acceder a los backups, restaurar datos, configurar infraestructura, iniciar la aplicación, validar y comunicar. El resultado medido es mucho más útil que el esperado.
Arquitecturas de referencia
Un ejemplo práctico con Proxmox
Un backup nocturno de VM no puede cumplir por sí solo un RPO de 15 minutos en una base de datos. Pueden requerirse diferentes métodos de protección dentro del mismo entorno virtual, como backups de base de datos compatibles con la aplicación o protección de registros de transacciones sobre los backups incrementales frecuentes de Proxmox Backup Server.
Un ejemplo práctico en homelab y pequeñas empresas
Un homelab puede definir un RPO de una hora y un RTO de cuatro horas para un gestor de contraseñas, pero ningún RPO formal para máquinas virtuales de prueba desechables. Una pyme puede definir un RPO de cuatro horas y un RTO de ocho horas para su base de datos contable, y un RPO de una hora con un RTO de cuatro horas para su portal de clientes. Los objetivos deben revisarse con quienes comprenden el impacto operativo, porque el equipo de TI no debe seleccionar cada objetivo de recuperación en solitario.
Tecnología, retención y disponibilidad
Ninguna tecnología por sí sola satisface automáticamente ambos objetivos.
AWS agrupa las estrategias de recuperación ante desastres con niveles crecientes de preparación y tiempos de recuperación decrecientes (backup y restauración, pilot light, warm standby y multirregión o multisitio), y recomienda pruebas periódicas para comprobar si la arquitectura cumple realmente sus objetivos.
El RPO no sustituye a la retención ni a la disponibilidad
Un RPO de una hora con 30 días de retención significa que el sistema busca puntos recuperables con no más de una hora de diferencia, conservando un historial seleccionado para problemas de detección tardía. Se necesitan ambos; consulta la guía de políticas de retención de backups para profundizar en la retención.
La alta disponibilidad y la recuperación ante desastres están relacionadas pero son distintas: un clúster de alta disponibilidad aún puede sufrir corrupción, ransomware o errores de administración, y un buen sistema de backup puede restaurar una aplicación sin ofrecer disponibilidad continua.
Errores frecuentes con el RPO y el RTO
Los sistemas tienen diferente valor para el negocio y distintas dependencias. Conviene definir niveles de carga de trabajo.
Los equipos técnicos pueden subestimar el coste de perder datos o sobreestimar la necesidad de una recuperación inmediata. Conviene involucrar a los responsables del sistema.
Cero pérdida de datos puede exigir replicación síncrona y una gestión de fallos diseñada con sumo cuidado. Es complejo y costoso.
Un trabajo completado no demuestra que el punto de recuperación sea utilizable. Es necesario probar la restauración.
El RTO abarca normalmente todo el proceso de interrupción y recuperación. Debe incluir tiempos de detección, decisión y validación.
Una aplicación no puede restablecerse antes de que la identidad, la red, el almacenamiento y las bases de datos estén listos. Conviene mapear el servicio completo.
La replicación puede propagar corrupción, ransomware y eliminaciones accidentales. Conviene mantener puntos de recuperación históricos independientes.
Un backup local puede cumplir el objetivo mientras la copia externa se queda rezagada muchas horas. Es necesario medir ambos.
Una programación de backups cada cuatro horas no puede respaldar con fiabilidad un RPO de 15 minutos. Conviene cambiar la arquitectura o ajustar el objetivo.
Los tiempos estimados de recuperación suelen ser optimistas. Es imprescindible realizar ejercicios cronometrados.
Lista de comprobación de RPO y RTO
0 / 20Preguntas frecuentes
El RPO mide cuánta pérdida de datos reciente resulta aceptable. El RTO mide cuánto tiempo puede permanecer no disponible el servicio antes de que deba restablecerse.
Significa que la recuperación puede basarse en un punto de hasta cuatro horas antes de la interrupción. La organización acepta la posibilidad de perder hasta cuatro horas de cambios recientes.
Significa que el servicio debe volver a su estado operativo acordado dentro de las cuatro horas posteriores a la interrupción.
No. La frecuencia de backup ayuda a determinar el RPO alcanzable, pero los puntos de recuperación fallidos, dañados, retrasados o inaccesibles pueden hacer que el RPO real sea mayor.
No siempre. El RTO puede incluir la detección, la toma de decisiones, el aprovisionamiento de infraestructura, la restauración, la configuración, la validación y el retorno de los usuarios al servicio.
Un RPO de cero busca evitar cualquier pérdida de datos. Lograrlo puede requerir replicación síncrona, protección transaccional a nivel de aplicación y un failover diseñado con cuidado. Las copias de seguridad por sí solas rara vez garantizan cero pérdidas de datos.
Un RTO de cero absoluto implicaría una ausencia total de interrupción. Las arquitecturas de alta disponibilidad y activo-activo pueden aproximarse a un servicio continuo, pero los fallos complejos aún pueden generar disrupciones.
Ambos son cruciales. Una recuperación rápida a partir de datos antiguos puede ser inaceptable, mientras que un punto de recuperación reciente que tarde días en restaurarse tampoco cumplirá los requisitos del negocio.
La replicación puede reducir el RPO al copiar los cambios con frecuencia o de forma continua. Conviene combinarla con puntos de recuperación retenidos, ya que la replicación también puede copiar corrupción o eliminaciones indebidas.
Las copias de seguridad proporcionan los datos de recuperación, pero el RTO también depende de la velocidad de restauración, la preparación de la infraestructura, el personal, las dependencias y las pruebas.
Las cargas de trabajo críticas deben probarse periódicamente y tras cambios importantes en la infraestructura o en las aplicaciones. El calendario debe reflejar el impacto en el negocio y la complejidad de la recuperación.
No. Los objetivos de recuperación deben reflejar la importancia de la carga de trabajo, la tasa de cambio de datos, las dependencias, el coste de recuperación y el impacto operativo.
Fijar objetivos que puedas demostrar
El RPO y el RTO transforman el backup y la recuperación ante desastres de intenciones vagas en expectativas medibles. El RPO define cuánto trabajo reciente se puede perder; el RTO define cuánto tiempo puede esperar la organización para recuperar el servicio.
Un plan de recuperación sólido elige objetivos que reflejan el impacto real en el negocio en lugar de cifras mínimas inalcanzables, construye una arquitectura capaz de cumplirlos y demuestra los resultados mediante pruebas. Comienza por la carga de trabajo más importante, define qué significa una recuperación utilizable, mide el proceso completo y resuelve las deficiencias antes de fijar cifras más ambiciosas en el plan.