

Uso de memoria en Prometheus: cómo los paneles dispararon la cardinalidad
Prometheus no se despierta una mañana cualquiera con la idea de devorar tu memoria RAM. Cuando el uso de memoria de Prometheus pasa de "saludable" a "¿por qué este pod está solicitando 64GB?", normalmente hay un motivo concreto detrás.
En la historia detrás de "Prometheus: cómo redujimos drásticamente el uso de memoria", el culpable fueron los paneles: métricas y etiquetas de alta cardinalidad alimentando vistas de Grafana que nadie había auditado con seriedad en mucho tiempo. El tráfico, la escala y los errores exóticos del motor TSDB tuvieron muy poco que ver.
La solución no requirió alterar parámetros de retención ni ajustes oscuros de almacenamiento. El equipo investigó qué residía verdaderamente en el bloque en memoria (head block) y por qué motivo estaba allí.
El momento en que descubres que no es "solo crecimiento"
Cualquier operador de Prometheus conoce la sensación. La memoria se incrementa poco a poco y asumes que es crecimiento orgánico debido a más servicios, más pods y más métricas. Cuando el consumo sube más rápido de lo que crece la carga de trabajo, algo no cuadra.
Ahí es donde arranca esta historia. En vez de añadir más hardware para tapar el problema, el equipo profundizó en la cardinalidad y abordó el uso de memoria como un síntoma que debía rastrearse hasta su origen. Lo que encontraron resulta dolorosamente familiar.
Alta cardinalidad: el multiplicador invisible
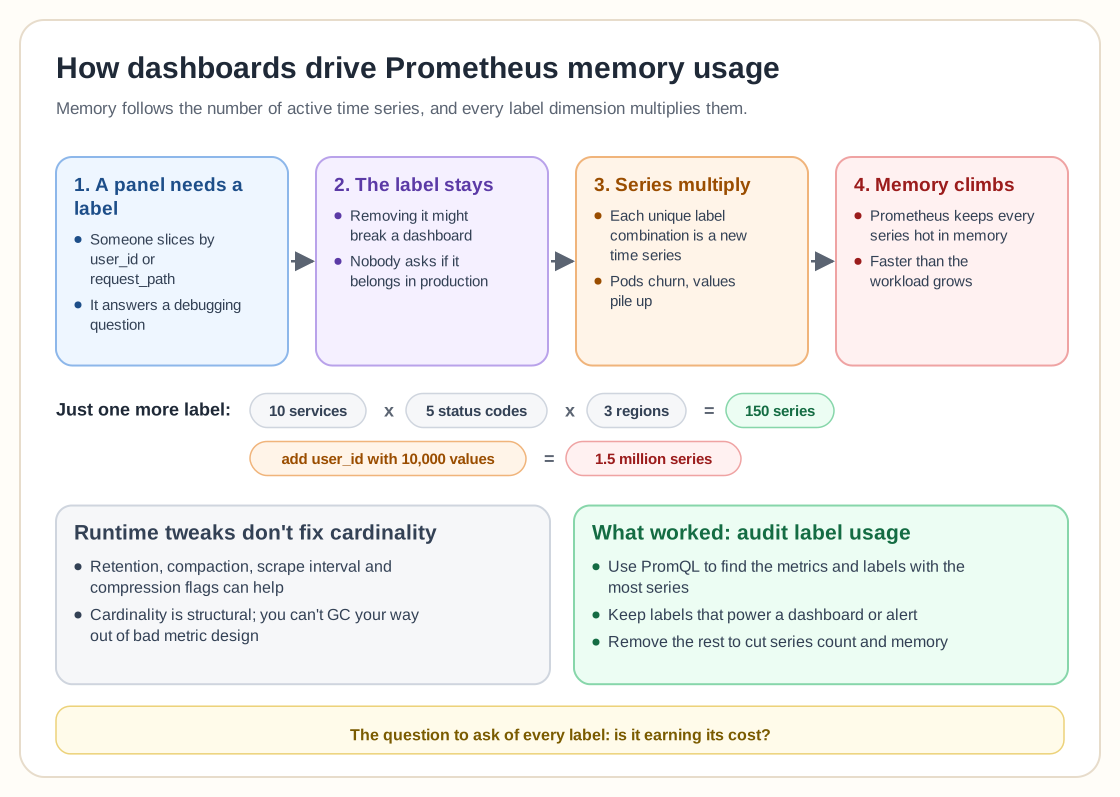
La memoria de Prometheus depende directamente del número de series temporales activas. Más combinaciones únicas de etiquetas significan más series temporales, y más series temporales implican más memoria. La relación es implacablemente lineal.
El equipo se centró en métricas y etiquetas de alta cardinalidad, especialmente las empleadas por los paneles de Grafana. Ese detalle importa, porque los paneles pueden hacer que un diseño de métricas deficiente parezca justificado. Alguien añade una gráfica que desglosa por user_id o request_path. Parece útil y responde a una duda puntual de depuración, pero nadie se pregunta si esa etiqueta encaja en una métrica de producción. Pasan las semanas, los despliegues se multiplican y los pods rotan; la etiqueta "temporal" termina generando decenas de miles de series distintas. Prometheus almacena diligentemente cada una de ellas.
Grafana no es el culpable, pero facilita los malos hábitos
Grafana no originó el problema, pero los paneles crean incentivos. Cuando una gráfica requiere una etiqueta concreta para funcionar, los ingenieros son reacios a eliminarla aunque esté inflando la cardinalidad.
El artículo describe cómo analizar qué métricas y etiquetas utilizaban realmente los paneles, lo que supone un cambio de enfoque sutil y muy provechoso. En lugar de limitarte a listar qué métricas existen o qué etiquetas son pesadas, te preguntas qué etiquetas están justificadas por un uso real. Si una etiqueta no alimenta de forma determinante un panel o una alerta, no tiene motivo para ocupar memoria.
PromQL como un bisturí
El artículo propone consultas PromQL muy útiles para localizar métricas de alta cardinalidad, y ese es justo el paso que la mayoría de los equipos se saltan. Sienten la presión del problema, asumen que conocen la causa y empiezan a eliminar exportadores o a modificar intervalos de scrape. PromQL puede mostrarte:
- Qué métricas acumulan más series.
- Qué etiquetas tienen la mayor cantidad de valores distintos.
- Qué combinaciones están disparando la cardinalidad.
Cuando interrogas a Prometheus sobre sí mismo, dejas de hacer conjeturas y empiezas a medir cuánto cuesta cada etiqueta. Ahí es donde nace la disciplina.
De "recopilar todo" a "recopilar con criterio"
Muchos entornos basados en Kubernetes arrancan con valores por defecto muy amplios: kube-state-metrics, cAdvisor, node exporter, controladores de ingress y mallas de servicios, todos extrayendo y exportando información con etiquetas minuciosas. Eso funciona hasta que deja de hacerlo.
Este equipo conservó las ventajas de Prometheus y eliminó aquellas métricas que, aunque estaban técnicamente disponibles, resultaban innecesarias en la práctica, lo que exige un cambio de mentalidad. La cultura de observabilidad a menudo aconseja recopilar ahora y analizar después. Prometheus penaliza esa estrategia: no va a comprimir tu falta de definición y mantendrá cada serie activa en memoria.
Los paneles como deuda técnica
Los paneles se acumulan como el código. Alguien diseña uno durante un incidente, otro equipo lo clona y un tercero incorpora una nueva etiqueta para ganar granularidad. Pronto, decenas de paneles dependen de combinaciones sutiles de etiquetas que nadie recuerda haber justificado, y retirar una etiqueta parece arriesgado. ¿Y si ese panel deja de funcionar o alguien necesita ese desglose durante una caída del servicio? Así, la etiqueta se mantiene y la memoria continúa subiendo.
Al vincular la cardinalidad con el uso en los paneles, el equipo transformó la pregunta: de "¿podemos permitirnos eliminar esta etiqueta?" pasaron a "¿está justificando esta etiqueta lo que cuesta mantenerla?".
Reducir memoria no es cuestión de parámetros
Cuando Prometheus se vuelve pesado, resulta tentador buscar ajustes de configuración en tiempo de ejecución: modificar la retención, ajustar la compactación, alargar el intervalo de scrape o activar opciones de compresión. Esas medidas pueden ayudar, pero no corrigen la cardinalidad, que es un problema estructural. El recolector de basura (GC) no puede compensar un mal diseño de métricas. Este equipo redujo el recuento de series eliminando etiquetas innecesarias de alta cardinalidad, lo cual representa un cambio de arquitectura más que una simple modificación de configuración.
El coste oculto de "solo una etiqueta más"
A los ingenieros les encantan las etiquetas porque flexibilizan las métricas, facilitan las segmentaciones y aportan potencia a los paneles. Sin embargo, cada nueva dimensión de etiquetas multiplica las series potenciales. Considera una métrica con:
- 10 servicios
- 5 códigos de estado
- 3 regiones
Eso arroja 150 series posibles. Añade user_id con 10,000 valores posibles y alcanzarás 1.5 millones, que es como desaparece la memoria en la práctica.
Lo peor es que la inmensa mayoría de los paneles no necesitan semejante desglose. Existe por si pudiera ser útil en algún momento, y Prometheus almacenará todo lo que le pidas que guarde.
Lo que enseña esta experiencia
El artículo presenta el resultado como una reducción radical de memoria, pero la enseñanza más amplia es que los sistemas de observabilidad precisan gobernanza. Sin ella, las métricas proliferan sin control igual que los logs: los paneles crecen sin supervisión, las etiquetas se multiplican y la memoria va detrás. Solucionarlo no requiere herramientas exóticas. Exige visibilidad sobre el volumen de series, disposición para cuestionar lo que dan por hecho los paneles y la disciplina de retirar etiquetas que no justifican su peso.
Prometheus escala si respetas su diseño
Estas historias de consumo excesivo de memoria comparten un patrón. Prometheus suele fallar por exceso de permisividad: guardará encantado millones de series e indexará cada etiqueta dinámica sin poner ningún freno. Esa es la trampa.
Este equipo hizo un ejercicio de introspección y auditó la higiene de sus propias métricas. No culparon al motor TSDB ni recurrieron de inmediato a otra base de datos de series temporales. Se preguntaron qué estaban almacenando y por qué, y esa sola pregunta merece formularse en cualquier instancia de Prometheus.
Si tu Prometheus se vuelve pesado
Pregúntate:
- ¿Qué métricas tienen el mayor número de series?
- ¿Qué etiquetas disparan la cardinalidad de valores?
- ¿Son realmente necesarias esas etiquetas para los paneles o las alertas?
- ¿Están los paneles condicionando el diseño de las métricas en lugar de ocurrir lo contrario?
- ¿Estás exportando etiquetas que cambian con cada despliegue?
Si no sabes las respuestas, tu gráfica de memoria probablemente sí las conoce, y no para de subir. Reducir el consumo de memoria se reduce a restar, y a veces la vía más rápida para aligerar Prometheus consiste en admitir que estás midiendo más de lo necesario.