

Cómo un equipo redujo la memoria de Prometheus de 60GB a 20GB y expuso la crisis de cardinalidad
La mayoría de los operadores de Prometheus chocan contra el mismo muro tarde o temprano. La interfaz web se vuelve lenta, las tareas de recolección empiezan a fallar, las consultas PromQL agotan el tiempo de espera y los paneles se quedan congelados el tiempo justo para hacerte dudar de tus decisiones profesionales. Entonces revisas el consumo de memoria y descubres que Prometheus está devorando sin inmutarse de 50 a 60GB de RAM. Un consumo a ese nivel suele anunciar que tu próxima gran incidencia ya viene de camino.
Un ingeniero describió con precisión ese escenario: un clúster donde Prometheus se había disparado hasta unos 60GB, con una fiabilidad de recolección en declive, consultas bloqueadas y una estabilidad general comprometida. La solución que encontraron consistió en una limpieza clara, directa y rigurosa.
The Silent Crisis KILLING Your Cluster: How We Slashed Prometheus Memory from 60GB to 20GB!
Los culpables: tres trampas de memoria previsibles
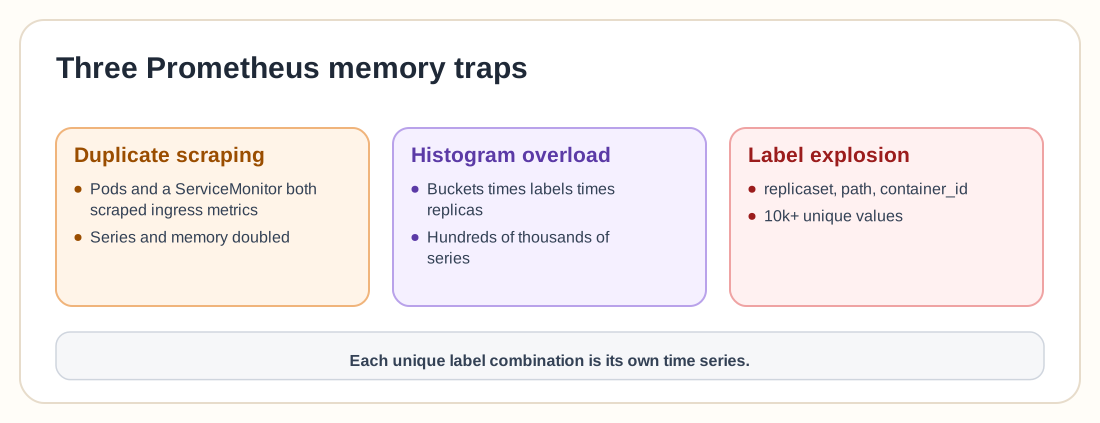
La investigación sacó a la luz tres trampas clásicas de memoria en Prometheus:
- Duplicate scraping
- Histogram overload
- Label explosion
Si llevas tiempo operando Prometheus en Kubernetes, es muy probable que hayas sufrido al menos una de ellas. La mayoría de los equipos terminan cayendo en las tres.
1. Raspado duplicado: el multiplicador accidental por 2
Prometheus recolectaba métricas de ingress tanto desde los propios pods como a través de un ServiceMonitor. Parece algo inofensivo, pero cada recolección duplicada multiplica por dos:
- El recuento de series temporales
- El uso de memoria
- La presión sobre el WAL
- La rotación de bloques en memoria (head blocks)
A menos que desdupliques aguas abajo, acabas de duplicar la cardinalidad de todo ese conjunto de métricas. No lo notas al instante, pero el impacto se acumula entre clústeres, y un pequeño descuido de configuración puede costarte decenas de gigabytes.
La corrección en este punto fue desactivar la recolección redundante a nivel de pod.
2. Sobrecarga de histogramas: muerte por exceso de buckets
Los histogramas son muy potentes y sumamente costosos. Métricas como *_duration_seconds_bucket pueden generar cientos de miles de series temporales cuando combinas muchos intervalos, múltiples variantes de etiquetas y numerosas réplicas. Si multiplicas buckets por etiquetas, pods y clústeres, y luego consideras el periodo de retención en el bloque de memoria, tu gráfico de consumo adopta una pendiente vertical.
Muchos exportadores activan los histogramas de forma predeterminada y rara vez los equipos revisan si realmente necesitan cada bucket o si se les están asociando etiquetas de alta cardinalidad. Prometheus termina actuando como un simple almacén masivo de histogramas.
3. Explosión de etiquetas: el monstruo de la cardinalidad
Este factor es el más peligroso. En el clúster analizado, etiquetas como las siguientes generaban más de 10k valores únicos:
replicasetpathcontainer_id
Cada combinación única de etiquetas constituye una serie temporal independiente. Si path incluye URLs sin normalizar con identificadores embebidos, si container_id cambia con cada despliegue o si replicaset rota de continuo, cada actualización crea miles de nuevas series temporales que Prometheus mantiene en RAM. Así es exactamente como está diseñado para funcionar.
La solución: limpieza metódica
Los pasos para sanear el entorno fueron directos:
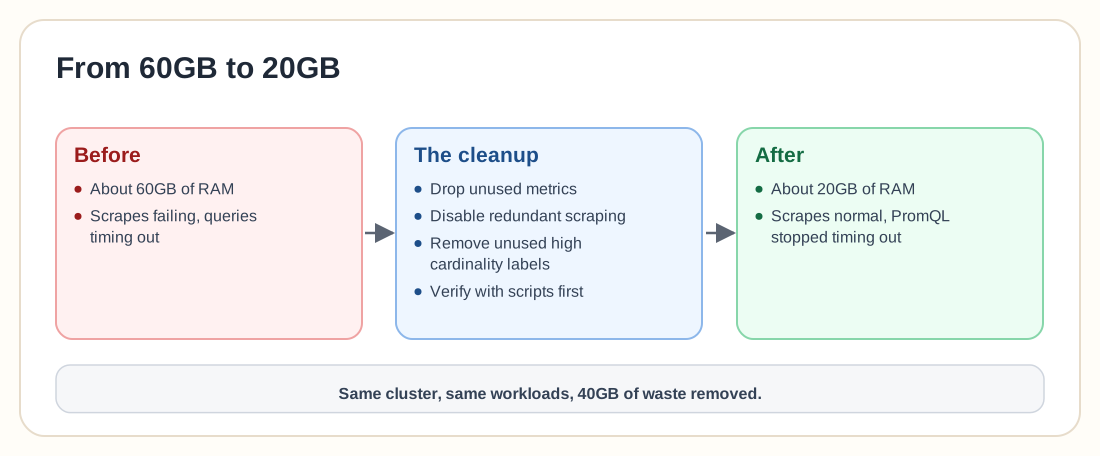
- Descartar métricas innecesarias (tras validar paneles y alertas)
- Desactivar la recolección redundante
- Eliminar etiquetas de alta cardinalidad que no se consultaban realmente
- Escribir scripts para auditar qué métricas era seguro suprimir
Este último punto es clave, ya que eliminar etiquetas a ciegas puede provocar errores de ingesta. Un moderador de la comunidad aportó una advertencia fundamental: labeldrop suprime la etiqueta, no la serie. Si esa etiqueta era necesaria para mantener la serie como única, borrarla provoca colisiones entre series duplicadas y fallos en la ingesta. Las series colapsan entre sí, y fusionarlas sin planificación desata el caos. El autor actualizó el artículo tras esta precisión.
Ese intercambio refleja muy bien el comportamiento de Prometheus que suele confundir a los equipos: ajustarlo exige máxima precisión.
El resultado: de 60GB a 20GB
Tras la limpieza, la memoria bajó de aproximadamente 60GB a unos 20GB y la estabilidad regresó. El raspado volvió a sus tiempos normales, la interfaz recuperó la agilidad y PromQL dejó de arrojar timeouts, todo dentro del mismo clúster y con las mismas cargas de trabajo. La diferencia de 40GB era puro desperdicio que se había conseguido erradicar.
Un patrón repetido entre equipos
La sección de comentarios demostró que muchos equipos enfrentan situaciones calcadas. Un usuario bromeaba con «se ríe en VictoriaMetrics». Otro respondía «NetData ;)». El ciclo se repite siempre:
- Prometheus crece.
- La memoria se dispara.
- Se culpa a la base de datos.
- Entran en escena otros motores de TSDB alternativos.
La inmensa mayoría de las explosiones de memoria en Prometheus proceden de la configuración externa: recolección duplicada, cardinalidad desbocada, histogramas sobredimensionados y el aluvión de métricas que Kubernetes genera por defecto. Una recomendación muy sólida en el hilo fue auditar las reglas predeterminadas de action: drop en kube-prometheus-stack, ya que las métricas del apiserver y de cAdvisor pueden sobrecargar fácilmente despliegues modestos. Kubernetes emite una cantidad masiva de métricas, e ingerirlas todas sin filtro es la vía directa hacia una crisis de memoria.
Prometheus no perdona la falta de rigor
Prometheus almacena con exactitud aquello que le indicas. No comprime malas decisiones de etiquetado, no te salva de una explosión de cardinalidad ni emite advertencias cuando los histogramas se multiplican por el número de réplicas. Asume que sabes lo que haces, lo que te otorga un gran poder operativo y mucho margen para perjudicarte.
Cuando alguien afirma que «Prometheus no escala», casi siempre quiere decir que «no gestionamos la cardinalidad».
Si tu consumo supera ahora los 40GB de RAM
Revisa esta lista de comprobación:
- ¿Estás recolectando el mismo endpoint dos veces?
- ¿Necesitas de verdad métricas a nivel de pod para cada servicio?
- ¿Cuántos buckets de histogramas estás exportando?
- ¿Estás adjuntando etiquetas de usuario o de ruta a métricas de alto volumen?
- ¿Aparecen identificadores de contenedor o hashes de réplicas en tus etiquetas?
- ¿Has auditado métricas en desuso recientemente?
- ¿Estás revisando las directivas de descarte en kube-prometheus-stack?
Si todavía no te has planteado estas cuestiones, es muy probable que el gráfico de memoria de tu servidor sea el siguiente en dispararse.
Prometheus con 20GB puede ser un sistema sano
El objetivo consiste en operar Prometheus con un propósito claro, lo que no siempre significa recortarlo al mínimo. Una instancia consumiendo 20GB para un clúster amplio de Kubernetes puede estar perfectamente sana. Una instancia consumiendo 60GB porque duplica métricas de ingress y rastrea cada ID de contenedor jamás generado está desperdiciando la mayor parte de esa memoria. En observabilidad, este nivel de disciplina escala mucho mejor que añadir más hardware.