

Prometheus vs Zabbix en 2026: ¿qué herramienta de monitoreo elegir?
Respuesta rápida sobre Zabbix frente a Prometheus: Prometheus se impone en Kubernetes e infraestructura en contenedores. Zabbix gana en servidores tradicionales, dispositivos de red y para equipos que buscan una solución de monitoreo con interfaz web y sistema de alertas listo para funcionar, sin requerir piezas adicionales.
En realidad no compiten por el mismo cometido. Prometheus se creó en SoundCloud para supervisar servicios efímeros que escalan de forma dinámica, justo las condiciones que genera Kubernetes por defecto. Zabbix se diseñó para monitorizar servidores, conmutadores y aplicaciones que suelen permanecer donde los colocas. Escoger entre ambos equivale principalmente a decidir en cuál de esos dos mundos operas en la práctica.
Comparativa rápida
| Prometheus | Zabbix | |
|---|---|---|
| Arquitectura | Scraping basado en pull | Basado en agentes (push) o sondeo sin agentes |
| Uso ideal | Kubernetes, contenedores, microservicios | Servidores, equipos de red, infraestructura mixta |
| Dificultad de configuración | Mayor: exportadores, service discovery, PromQL | Menor: interfaz web, plantillas, configuración guiada |
| Almacenamiento | BD de series temporales para alta cardinalidad | Basado en SQL (MySQL/PostgreSQL), requiere mantenimiento |
| Alertas | Alertmanager (componente independiente) | Integradas, configuradas en la misma interfaz |
| Paneles | Sin interfaz nativa avanzada, se combina con Grafana | Paneles y pantallas integrados |
| Lenguaje de consultas | PromQL | Expresiones de activación sencillas |
| Licencia | Apache 2.0, código abierto total | GPL, código abierto (soporte comercial disponible) |
Arquitectura: pull frente a push
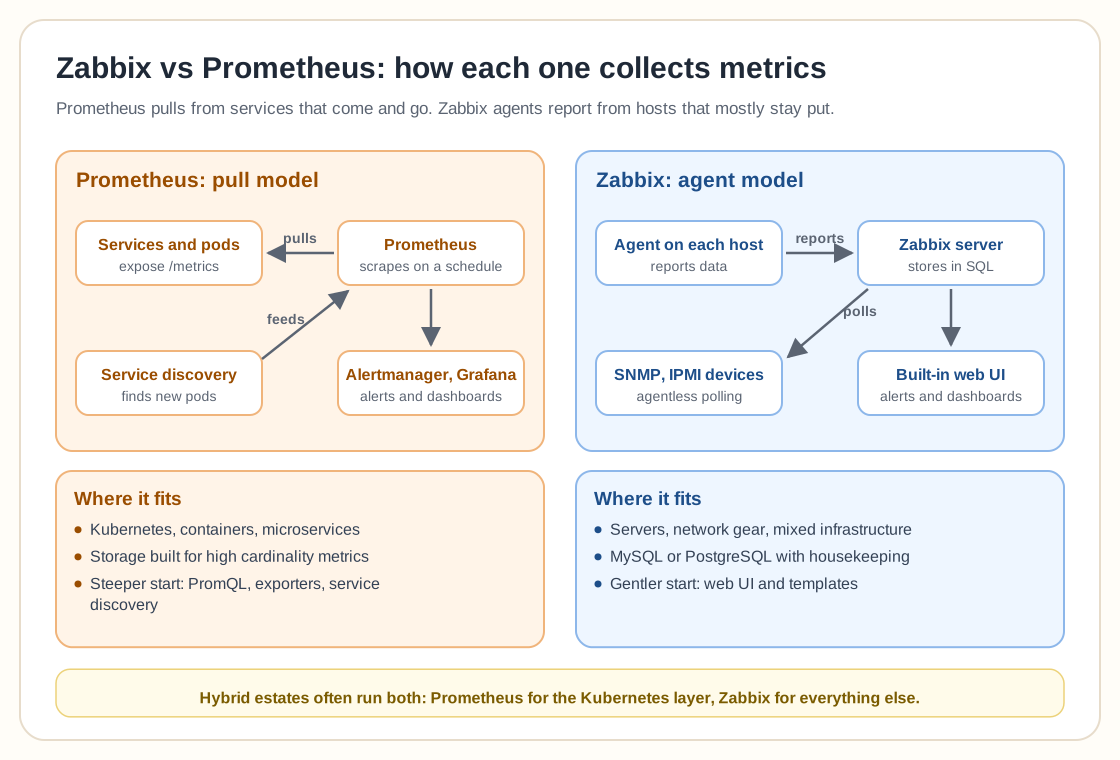
Prometheus extrae métricas de endpoints periódicamente: tu servicio expone un endpoint HTTP /metrics y Prometheus realiza peticiones pull sobre él. Este modelo resulta ideal cuando las instancias de los servicios aparecen y desaparecen continuamente, ya que Prometheus puede apoyarse en el descubrimiento de servicios de Kubernetes para localizar nuevos pods en cuanto arrancan.
Zabbix recurre por defecto a la monitorización basada en agentes, donde un agente ligero se ejecuta en cada host y envía los datos al servidor de Zabbix, aunque también admite sondeo sin agentes mediante SNMP, IPMI y comprobaciones de red sencillas. Este modelo asume que los hosts son estables: registras un equipo una vez y continúa informando hasta que lo retiras. En un entorno de máquinas virtuales de larga duración y servidores físicos, esa premisa es lógica. En un escenario donde los pods se reprograman cada pocos minutos, se transforma en un problema constante de mantenimiento.
Adaptación a Kubernetes y entornos cloud-native
Aquí es donde habitualmente se decide la balanza. Prometheus es un proyecto graduado de la CNCF y el estándar de facto para métricas en Kubernetes; kube-state-metrics, node_exporter y la inmensa mayoría de las herramientas nativas de Kubernetes exponen métricas en formato Prometheus de forma nativa. Si ejecutas Kubernetes, obtienes un flujo de métricas operativo casi sin esfuerzo.
Zabbix puede monitorizar Kubernetes técnicamente (existen plantillas comunitarias y un plugin de Zabbix para Kubernetes), pero nadas contracorriente. Estarías consultando una API concebida para ser leída mediante scraping y pierdes el descubrimiento automático de servicios que Prometheus ofrece de manera nativa.
Alertas y paneles
El sistema de alertas de Zabbix es objetivamente más sencillo para empezar: activadores (triggers), acciones y pasos de escalado conviven en la misma interfaz donde configuras hosts y elementos. Para un equipo pequeño, eso supone menos piezas en movimiento.
Prometheus separa responsabilidades. Alertmanager gestiona el enrutamiento, la agrupación y el silenciamiento de alertas, mientras que Grafana (o la interfaz básica propia de Prometheus) asume la visualización. Esto resulta más potente cuando lo dominas, ya que las reglas de agrupación e inhibición de Alertmanager previenen avalanchas de alertas mucho mejor que el esquema de escalado de Zabbix, pero también exige aprender y operar dos herramientas adicionales.
Almacenamiento y escala
El almacenamiento de series temporales de Prometheus está diseñado para métricas de alta cardinalidad (miles de pods con etiquetas únicas), que es exactamente lo que generan los entornos de contenedores. Tiene ciertas particularidades operativas conocidas a gran escala. El consumo de memoria puede dispararse con una cardinalidad muy elevada, motivo por el cual los equipos con despliegues muy amplios suelen incorporar Thanos o Cortex para almacenamiento a largo plazo y federación.
Zabbix almacena la información en una base de datos SQL tradicional (MySQL o PostgreSQL), lo que implica que el mantenimiento típico de base de datos (particionamiento, políticas de retención y optimización de índices) pasa a formar parte de la gestión de Zabbix a gran escala. Soporta recuentos elevados de dispositivos (miles de servidores) sin problemas, pero no fue diseñado para métricas dinámicas de alta cardinalidad.
Nuestra elección según el escenario
- Si utilizas Kubernetes o cargas mayoritariamente en contenedores: Prometheus, combinado con Grafana. Es el camino más directo y el que la mayoría de las herramientas ya dan por hecho.
- Servidores tradicionales, equipos de red o una infraestructura mixta física y virtual: Zabbix. El soporte SNMP, las plantillas de dispositivos y una interfaz web integrada reducen el trabajo de montaje.
- Infraestructura híbrida con ambos entornos: muchos equipos utilizan ambos sistemas en paralelo, empleando Prometheus para la capa de Kubernetes y Zabbix para el resto, alimentando en ocasiones un panel común de Grafana.
- Un equipo reducido que busca una sola herramienta y una única interfaz: Zabbix, sencillamente porque es un único sistema que aprender en vez del conjunto de Prometheus + Alertmanager + Grafana.
Lecturas relacionadas
Para conocer con más detalle cómo encaja Checkmk en esta comparativa, consulta nuestro análisis de Zabbix vs Checkmk vs Prometheus. Si tu duda sobre infraestructura se centra específicamente en la monitorización de redes de código abierto, Zabbix vs LibreNMS aborda esa comparativa en profundidad. Para obtener una visión arquitectónica global sobre la gestión de Zabbix a escala empresarial, consulta nuestra guía de Zabbix Enterprise Monitoring.
Preguntas frecuentes
¿Es Prometheus mejor que Zabbix?
Ninguno es universalmente mejor. Prometheus es más adecuado para Kubernetes, contenedores y cargas de trabajo nativas de la nube porque fue diseñado para ese entorno. Zabbix es mejor para infraestructuras tradicionales como servidores físicos, equipos de red y entornos mixtos, ya que incluye agentes, soporte SNMP y una interfaz web lista para usar.
¿Puede Prometheus monitorizar dispositivos de red como lo hace Zabbix?
Sí, pero solo con herramientas complementarias. Prometheus requiere exportadores como snmp_exporter para consultar dispositivos SNMP, y debes configurarlos y mantenerlos tú mismo. Zabbix incorpora de serie la monitorización SNMP y plantillas de dispositivos, lo que permite poner en marcha la monitorización de red con mayor rapidez.
¿Necesito Grafana si utilizo Prometheus?
No de forma estricta, pero casi todo el mundo los combina. Prometheus dispone de un explorador de expresiones básico integrado, pero Grafana es donde realmente se diseñan los paneles, las interfaces de alertas y la visualización de múltiples fuentes. Zabbix, en cambio, incluye sus propios paneles y no requiere una segunda herramienta.
¿Cuál es más fácil de aprender, Prometheus o Zabbix?
Zabbix ofrece una curva de aprendizaje inicial más suave: lo instalas, añades un host y sus plantillas te proporcionan métricas de inmediato mediante una interfaz web. Prometheus requiere comprender PromQL, exportadores y descubrimiento de servicios antes de resultar útil, lo que exige un esfuerzo inicial mayor aunque compensa en entornos dinámicos.