

Alternativas a Opsgenie en 2025: a qué herramientas migran los equipos de DevOps
Si llevas suficiente tiempo gestionando guardias, seguro que conoces la sensación: tu herramienta de alertas dispara otro aviso a las 3 a. m. y, en vez de pensar «menos mal, el sistema funciona», piensas «otra vez esto no». Ahí es donde parecen encontrarse muchos equipos que usan Opsgenie en 2025. No están furiosos ni entusiasmados, simplemente están cansados.
Opsgenie Is OUT: Why DevOps Teams Are Switching Incident Tools (Top 5 Alternatives)
El debate sobre alternativas ha crecido con fuerza últimamente y el patrón resulta evidente. Los equipos no buscan únicamente la última novedad llamativa: están hartos de herramientas que no siguen el ritmo de cómo funcionan las guardias modernas y quieren una solución que no requiera cinta aislante, seis scripts y una promesa a los dioses del monitoreo para mantenerse en pie.
Si te preguntas si tu equipo es el único que valora migrar, ten por seguro que no es así. Una cantidad llamativa de ingenieros ya ha dado el salto, y sus motivos dibujan un panorama muy claro de cómo está evolucionando la respuesta a incidentes.
Por qué Opsgenie pierde terreno
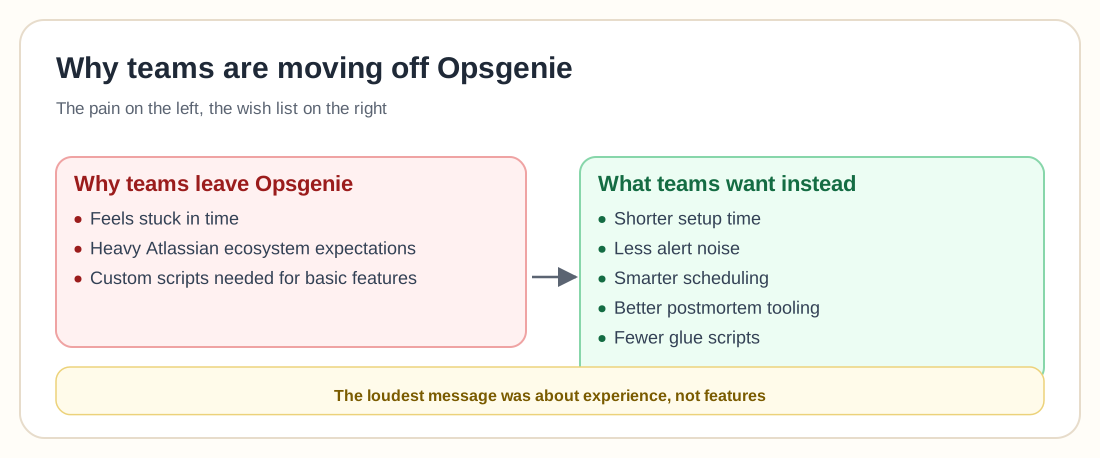
Opsgenie no es un mal producto, pero acusa el paso del tiempo, y los equipos que dependen de él acaban agotados. En las conversaciones destacan tres temas recurrentes.
-
La herramienta parece anclada en el pasado. Se percibe que la plataforma no ha evolucionado hacia donde los equipos de guardia realmente necesitan. Los usuarios señalan las mismas rarezas de interfaz, fricciones de flujo de trabajo y problemas de ruido en las alertas de los que llevan quejándose años.
-
La dependencia del ecosistema de Atlassian pesa demasiado. Opsgenie suele rendir mejor únicamente si ya estás metido de lleno en el universo de Jira, lo que encaja mal en equipos híbridos, multicloud o con un abanico variado de herramientas.
-
Los ingenieros buscan flexibilidad sin tener que programarlo todo mediante scripts. Muchos usuarios explican cómo añaden lógica personalizada solo para conseguir funciones básicas. Otros comentan que pasan más tiempo administrando Opsgenie que atendiendo incidentes, algo que resulta poco práctico.
Hay además un cambio más sutil: los equipos cuidan mucho más su carga mental y toleran menos la fricción operativa. Si una herramienta no filtra el ruido, no facilita las rotaciones ni gestiona la complejidad con fluidez, consideran que no merece la pena conservarla.
A qué herramientas está migrando la gente
Los caminos de migración varían, pero ya despuntan opciones favoritas claras, y cada una resuelve un punto de fricción concreto que Opsgenie no lograba solucionar.
1. Incident.io para quienes buscan una mejora moderna y directa
Si un nombre se repite por encima de los demás, es este. A los usuarios les gusta su enfoque moderno sin complejidades añadidas, y la sensación de que funciona nada más instalarlo es su mayor argumento de venta.
Varios aspectos que los ingenieros destacan:
- Reduce el ruido de las alertas sin exigir horas de configuración.
- La programación de turnos de guardia es sencilla y huye de complejidades corporativas innecesarias.
- Integra todo en Slack de forma limpia y natural.
- Consigue que los análisis post mortem no parezcan un castigo.
Un ingeniero describía así su evaluación: «No queríamos una herramienta que tuviéramos que vigilar durante el Black Friday. Incident.io no estorbó en ningún momento». Es probablemente el mayor elogio que se le puede dedicar a una solución de guardias.
2. Datadog On-Call para equipos que ya viven en Datadog
Se nota de inmediato quién lleva años apostando por Datadog: son quienes describen la migración como bastante sencilla porque todas las piezas encajaron a la primera.
Sus puntos fuertes son evidentes:
- Métricas, APM, logs, alertas y avisos de guardia conviven en una misma plataforma.
- Se acabaron las integraciones independientes que mantener.
- Menor carga cognitiva para los equipos que ya trabajan a diario dentro de Datadog.
El inconveniente previsible es el coste. Incluso quienes dieron el paso reconocen que los precios de Datadog siguen pareciendo desorbitados. Aun así, la comodidad suele imponerse, sobre todo en equipos que ya se ven desbordados entre tantos paneles.
3. FireHydrant para equipos que necesitan automatización seria en incidentes
FireHydrant goza de una sólida reputación entre los SRE que buscan procesos de respuesta estructurados, repetibles y bien orquestados. Es una solución de peso pensada para organizaciones que exigen un control exhaustivo.
Lo más valorado por sus usuarios:
- Una herramienta de migración que exporta tu configuración de Opsgenie a código en Terraform.
- Cronologías detalladas de incidentes sin necesidad de redactarlas a mano.
- Múltiples puntos de integración y automatización para empresas con departamentos de operaciones consolidados.
Requiere más trabajo de configuración inicial: ese es el peaje habitual entre control total y comodidad inmediata.
4. Rootly para organizaciones con flujos intensivos en Slack
Rootly también apareció con frecuencia en las conversaciones. Los equipos destacan cómo se integra en organizaciones centradas en Slack, situándose en un punto medio equilibrado entre una herramienta excesivamente rígida y tener que construirlo todo desde cero.
Puntos que gustaron a los usuarios:
- Rotaciones en la sombra y sincronización con grupos de usuarios de Slack.
- Planificación de turnos que tiene en cuenta las vacaciones (algo que los usuarios de Opsgenie reclamaban desde hace años).
- Integración sencilla con Jira.
Algunos usuarios señalaron notificaciones algo insistentes, pero la valoración general fue muy positiva, sobre todo en equipos que quieren resolverlo todo allí donde ya tienen sus conversaciones.
5. Alertas de Jira Service Management para quienes ya están atados a Atlassian
Esta era la opción más previsible y también una de las más prácticas. Quienes optaron por esta vía no buscaban innovar: necesitaban algo estable, ya integrado y que no requiriese convencer al departamento de seguridad.
Los comentarios apuntaban a lo siguiente:
- La migración resultó directa.
- Las integraciones se trasladaron con el mínimo esfuerzo.
- Menos necesidades de formación para el resto de la empresa.
No es la herramienta más avanzada, pero representa el camino de menor fricción si Jira domina tu operativa diaria.
Y luego está PagerDuty
PagerDuty salió a relucir a menudo, aunque no siempre con entusiasmo. Sigue considerándose fiable y mantiene su estatus de opción por defecto en el sector, pero los ingenieros no mostraron gran ilusión: palabras como «caro», «estancado» o «acomodado» aparecieron de forma constante.
La impresión general era: «PagerDuty funciona, pero no refleja hacia dónde va el sector». Los equipos buscan utilidades que den la sensación de haberse construido en esta década.
Opciones secundarias: otras herramientas en el radar
Otras herramientas más pequeñas también tuvieron su espacio:
- ilert gana presencia en equipos que buscan alertas, páginas de estado y desvío de llamadas en una sola consola.
- HeyOnCall está diseñada específicamente como una alternativa más ligera a los avisadores tradicionales.
- Grafana IRM resulta atractiva si tu pila de observabilidad ya se apoya fuertemente en Grafana.
- All Quiet interesa a organizaciones europeas y a usuarios habituales de Microsoft Teams.
- Zenduty genera opiniones divididas tras su adquisición: algunos valoran la integración mientras otros protestan por subidas drásticas de precio.
Estas opciones no copan el debate, pero se están abriendo hueco en aquellos puntos donde los viejos gigantes han perdido el contacto con el día a día.
Las expectativas cambian al mismo ritmo que las herramientas
Los fabricantes deberían tomar buena nota de esto: el mensaje más rotundo de los ingenieros gira en torno a la experiencia de uso por encima de la lista de funciones.
Piden menor tiempo de configuración, menos ruido en las alertas, flujos de trabajo más ágiles, mejores herramientas de post mortem, calendarios más inteligentes y menos scripts para pegarlo todo. Por encima de todo, quieren un producto que no suponga una carga adicional, porque las guardias ya son lo bastante duras por sí solas. Las plataformas modernas de respuesta a incidentes están ganando terreno justo porque reducen la carga de trabajo en lugar de incrementarla.
¿Deberías abandonar Opsgenie?
Si tu sistema de alertas se sostiene a base de apaños, parece desfasado o resulta más difícil de mantener cada trimestre, probablemente te convenga replantearlo. No necesitas inventar una nueva filosofía de incidentes, solo contar con herramientas que no te compliquen la vida.
Atendiendo a lo que están haciendo los equipos en la práctica, este es el resumen:
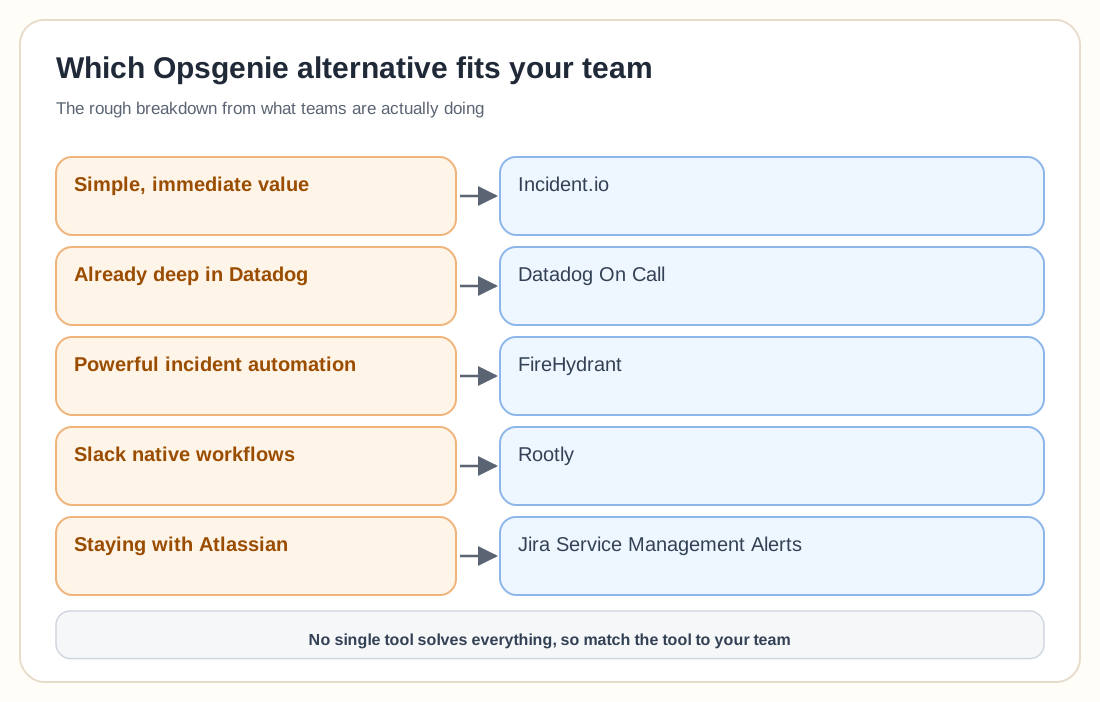
- Para sencillez y valor inmediato, elige Incident.io.
- Si ya estás metido de lleno en Datadog, Datadog On-Call te simplifica el panorama.
- Si necesitas automatizaciones potentes, FireHydrant es tu mejor opción.
- Para flujos nativos en Slack, Rootly encaja con esa cultura.
- Si te mantienes en Atlassian, las alertas de JSM son la ruta menos traumática.
Ninguna herramienta de esta lista lo resuelve todo por sí sola, y Opsgenie tampoco lo hace ya. Los ingenieros están cansados de arrastrar flujos heredados a la gestión moderna de incidentes y buscan soluciones acordes a cómo trabajan hoy. Viendo el ritmo al que migran los equipos, la época de «quedarse en Opsgenie solo porque ya está contratado» toca a su fin. Si tus herramientas no evolucionan con tu equipo, lo más probable es que ya te estén frenando.