

Todos quieren observabilidad, pero nadie sabe por dónde empezar
El momento en que el monitoreo deja de ser suficiente
En algún momento, casi todo equipo de infraestructura choca contra el mismo muro: el monitoreo tradicional empieza a parecer... insuficiente. Los paneles están ahí, las alertas saltan y los registros se acumulan, pero cuando algo se rompe dentro de un sistema distribuido, los ingenieros siguen pasando horas intentando averiguar qué ha pasado realmente.
Esa es exactamente la situación que describía un proveedor de servicios gestionados mientras intentaba hacer la transición del monitoreo tradicional a la observabilidad. Su entorno incluía infraestructura multinube, sistemas locales on-premise, clústeres de Kubernetes, capas de red, canalizaciones de automatización y herramientas de seguridad. Ya contaban con soluciones como Instana y Turbonomic, pero seguían sintiendo que faltaba algo: la base teórica detrás de la práctica.
No estaban solos. En todo el sector, los equipos están adoptando herramientas de observabilidad más rápido de lo que aprenden los conceptos en los que se basan. El resultado es una dinámica extraña en la que las empresas despliegan plataformas sofisticadas de telemetría, pero siguen teniendo dificultades para entender qué significa realmente la observabilidad.
La primera confusión: la observabilidad no es una herramienta
Uno de los errores más comunes aparece casi de inmediato cuando los equipos empiezan a interesarse por la observabilidad. Asumen que se trata de una categoría de producto.
Varios ingenieros experimentados rechazan de plano esa idea. Desde su punto de vista, la observabilidad consiste en ser capaz de responder preguntas sobre tu sistema a partir de datos de telemetría, y elegir el proveedor o la plataforma adecuada es un tema secundario. Como afirmó un ingeniero sin rodeos: trata la observabilidad como la capacidad de responder preguntas nuevas a partir de la telemetría, no como una elección de herramienta.
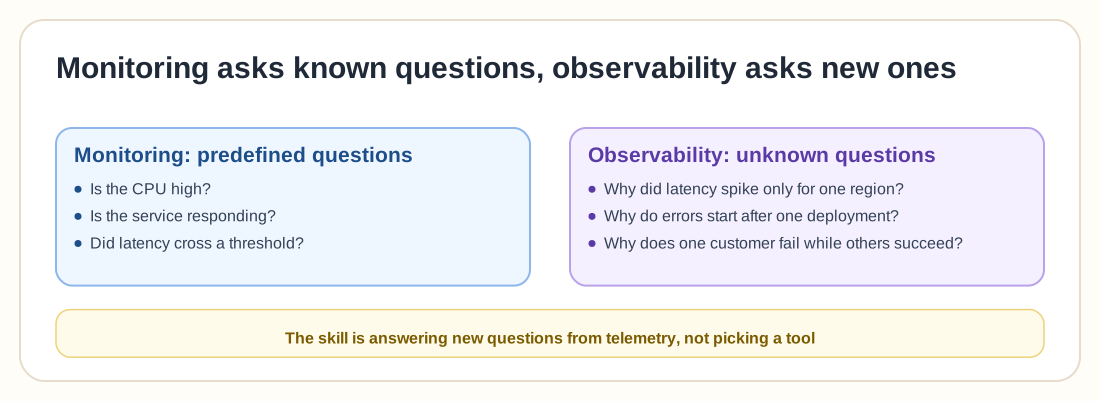
Esa diferencia importa mucho más de lo que parece. El monitoreo suele centrarse en preguntas predefinidas. ¿Está alta la CPU? ¿Responde el servicio? ¿Ha superado la latencia cierto umbral?
La observabilidad traslada el foco hacia preguntas desconocidas. ¿Por qué se disparó la latencia solo en una región? ¿Por qué aparecen errores únicamente después de un despliegue concreto? ¿Por qué fallan las peticiones de un solo cliente mientras las de los demás funcionan?
El objetivo es que el sistema proporcione suficientes señales para investigar problemas que nadie había anticipado de antemano.
La base teórica que casi todos se saltan
Otro tema recurrente entre ingenieros experimentados es la importancia de la teoría. Mucha gente salta directamente a herramientas como Grafana, Datadog o Dynatrace, pero una comprensión sólida de la observabilidad proviene en realidad de entender los sistemas distribuidos y la ingeniería de fiabilidad.
Varios ingenieros recomiendan empezar por recursos fundamentales como el libro Observability Engineering, junto con los materiales de SRE de Google sobre SLIs y SLOs. Esos textos se centran menos en paneles y más en el comportamiento del sistema. Explican cómo definir indicadores de nivel de servicio, cómo medir la fiabilidad y cómo razonar sobre sistemas a gran escala bajo condiciones de fallo.
Una vez que esos conceptos encajan, las herramientas empiezan a parecer más instrumentos de trabajo que soluciones mágicas.
Una ruta de aprendizaje práctica
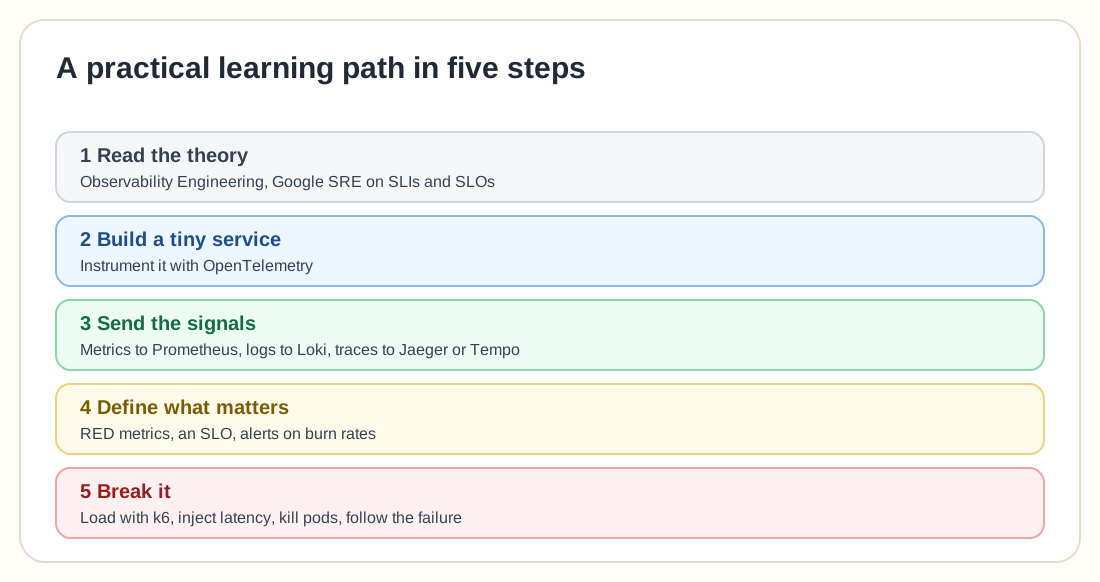
Cuando los ingenieros con experiencia explican cómo aprender observabilidad, sus consejos suelen seguir un patrón similar: empieza por la teoría y luego construye algo pequeño.
Una recomendación habitual es crear un servicio diminuto y conectarlo de extremo a extremo con telemetría. Instrumenta el servicio usando OpenTelemetry y envía métricas a Prometheus, registros a Loki y trazas a sistemas como Jaeger o Tempo. Luego define algunas señales clave, como las métricas RED de tasa de peticiones, errores y duración. Añade un SLO y crea alertas basadas en tasas de consumo de presupuesto (burn rates).
Después de eso, haz algo que muchos ingenieros evitan: rompe el sistema. Genera carga con herramientas como k6, inyecta latencia de red y elimina pods dentro de clústeres de Kubernetes. Observa cómo responde la telemetría y rastrea el fallo a través de métricas, registros y trazas.
Ese tipo de experimentación convierte la observabilidad de un concepto abstracto en algo tangible, porque resulta mucho más fácil de entender cuando estás viendo fallar un sistema en tiempo real.
Por qué los proveedores complican el debate
Otra frustración que surge con frecuencia en los debates sobre observabilidad es la influencia comercial de los proveedores. El término mismo ha sido deformado por el marketing durante la última década. Las plataformas de monitoreo empezaron a rebautizarse como plataformas de observabilidad, a veces sin cambiar gran cosa en la tecnología subyacente.
Un ingeniero describió la situación con crudeza: los proveedores han "manoseado el mensaje hasta la saciedad" para intentar capturar el mercado.
Esa presión comercial suele desdibujar la frontera entre monitoreo y observabilidad. El monitoreo se centra en modos de fallo conocidos, mientras que la observabilidad se enfoca en descubrir los desconocidos. Puede que las herramientas se solapen, pero la filosofía detrás de cada una es muy distinta.
Los orígenes que casi ningún ingeniero conoce
Curiosamente, la observabilidad no nació en absoluto en el mundo del software. El concepto proviene de la teoría de control, una rama de la ingeniería desarrollada hace décadas para comprender sistemas dinámicos complejos. En teoría de control, se considera que un sistema es observable si su estado interno se puede deducir a partir de sus salidas externas.
Esa idea se traslada de forma sorprendente a los sistemas de software distribuidos. Las aplicaciones producen señales como métricas, registros, trazas y eventos, y los ingenieros analizan esas señales para deducir qué está haciendo el sistema por dentro.
Entender ese origen ayuda a desviar el foco de los paneles y dirigirlo hacia las señales de datos. En lugar de preguntar qué herramienta comprar, los equipos empiezan a preguntarse qué señales necesitan.
La situación de la infraestructura moderna
Parte de la razón por la que la observabilidad ha cobrado tanta relevancia es el giro hacia arquitecturas nativas de la nube. Los sistemas de software anteriores eran relativamente autónomos. Las aplicaciones se ejecutaban en unos pocos servidores y monitorearlas era sencillo.
Los sistemas modernos son muy diferentes. Los microservicios se dispersan por múltiples clústeres, los contenedores aparecen y desaparecen constantemente y las peticiones de red rebotan a través de decenas de servicios antes de volver a los usuarios. En estos entornos, el monitoreo tradicional se queda corto porque los ingenieros no pueden anticipar cada modo de fallo posible.
La observabilidad ayuda a cubrir ese vacío. Al recopilar telemetría detallada en todo el sistema, los ingenieros adquieren la capacidad de investigar incidentes incluso cuando el patrón de fallo nunca se había previsto.
Por qué aprender observabilidad resulta abrumador
Para quienes empiezan, el gran reto es la enorme cantidad de materias implicadas. La observabilidad toca casi cada capa de la infraestructura, desde la arquitectura en la nube, las redes y Kubernetes hasta el rastreo distribuido, el diseño de métricas, los canales de registros, la ingeniería de fiabilidad y las pruebas de rendimiento. Es fácil sentirse perdido.
Algunos ingenieros sugieren abordar el reto paso a paso. Comienza por entender los fundamentos de la infraestructura, como las redes en la nube, la orquestación de contenedores y los patrones de comunicación entre servicios. Luego céntrate en las tres señales principales de telemetría: registros, métricas y trazas.
La habilidad que de verdad cuenta es aprender a interpretar esas señales con coherencia. Una vez que sabes descifrarlas, todo lo demás resulta más sencillo.
La mentalidad que desarrolla la observabilidad
La observabilidad enseña una mentalidad específica. En lugar de preguntar "¿Qué panel debería mirar?", los ingenieros empiezan a preguntarse: "¿Qué pregunta estoy intentando responder?".
Ese cambio transforma la forma de instrumentar los sistemas. La telemetría deja de ser algo que recopilas solo porque una herramienta te lo pide, y las señales pasan a ser elecciones deliberadas pensadas para explicar el comportamiento real del sistema.
Una buena observabilidad ayuda a los ingenieros a solucionar caídas más rápido, y además les permite entender sus sistemas con mucha mayor profundidad.