

Cómo el modo de CPU host de Proxmox ralentizó todo un servidor Windows RDS
Cuando todo parece ir bien pero los usuarios dicen que va lento
Los problemas de rendimiento más inquietantes son los que no aparecen en las métricas. El uso de CPU parece normal, la memoria no está bajo presión y los paneles de monitoreo siguen tranquilos, pero los usuarios no dejan de quejarse de que algo no va bien.
Eso es exactamente lo que pasó en un entorno de producción con un servidor Windows RDS para una docena de usuarios, más o menos, sobre un sistema Xeon E5-2650 v3. Sobre el papel, nada apuntaba a una crisis. El uso de CPU rondaba el 16 por ciento y el de memoria el 37 por ciento, y hasta los benchmarks sintéticos apenas mostraban cambios. La parte humana del sistema contaba otra historia: las sesiones iban con retraso, las aplicaciones titubeaban y las tareas pequeñas pesaban más de lo que deberían.
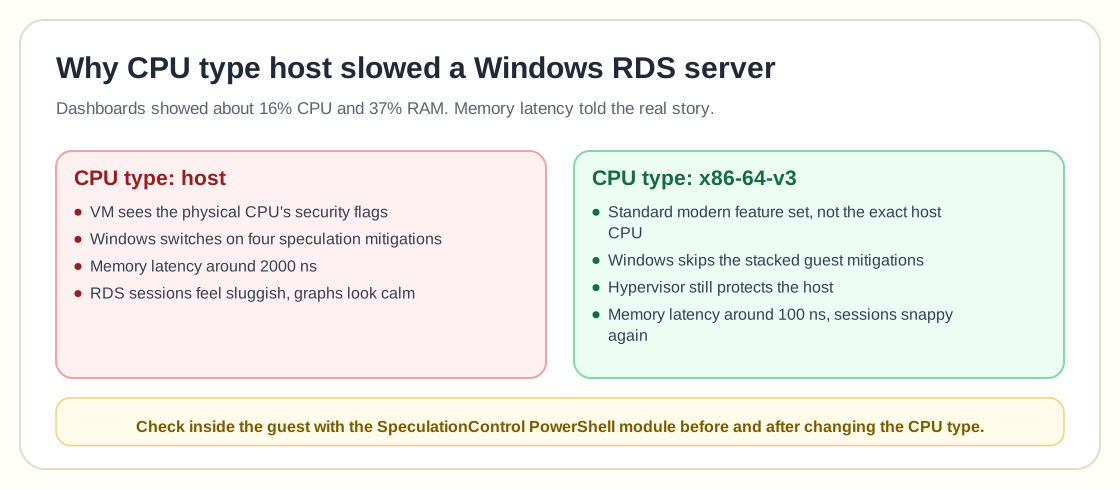
La sorpresa llegó después. El culpable resultó ser un modo de CPU que muchas guías recomiendan sin pensarlo mucho, "host", y no la capacidad del hardware ni una mala configuración en el sentido habitual. En este caso, ese único ajuste desencadenó una reacción en cadena que disparó la latencia de memoria dentro de la máquina virtual Windows. El acceso a memoria pasó de unos 100 nanosegundos a unos 2000 nanosegundos, un cambio sutil que hizo mucho daño.
El modo de CPU "host" que parecía la mejor opción
En los entornos de virtualización, el tipo de CPU que se presenta a una máquina virtual importa más de lo que muchos administradores creen. Plataformas como Proxmox te dejan elegir entre varios modelos de CPU, incluidos algunos genéricos como x86-64-v3, o pasar directamente la CPU del host a la VM.
A primera vista, "host" parece la elección obvia. Expone todas las capacidades del procesador físico a la máquina virtual, y muchas guías la presentan como la opción de mayor rendimiento. Si no te importa la migración en vivo entre nodos, suena casi a una mejora de rendimiento gratis.
Esa suposición guió la configuración de este entorno. El sistema se había migrado antes desde VMware, donde decisiones parecidas parecían seguras, y la documentación empujaba en la misma dirección: si el rendimiento importa y la migración no es una prioridad, el modo host aparece a menudo entre las recomendaciones.
Sin embargo, el ajuste de CPU host también pasa directamente a la máquina virtual los flags de CPU relacionados con la seguridad, y ahí es donde las cosas se complicaron. Un ingeniero resumió la experiencia sin rodeos: seguir la guía oficial y los tutoriales habituales le llevó a tener máquinas virtuales Windows más lentas.
Windows vio los flags de CPU y activó todas las mitigaciones
La raíz del problema está en cómo responden los sistemas operativos modernos a las vulnerabilidades de CPU. En la última década, fallos de hardware como Spectre y Meltdown obligaron a los sistemas operativos a implementar mitigaciones pesadas para proteger el aislamiento de la memoria.
Cuando una VM usa el modo de CPU host, hereda los mismos flags de CPU que expone el hardware físico. Windows ve esos flags y supone que tiene que activar varias mitigaciones de seguridad a nivel de sistema operativo, y esa decisión tiene consecuencias.
En el caso que desencadenó esta investigación, había cuatro mitigaciones distintas relacionadas con la ejecución especulativa activas dentro de la VM Windows. El equipo lo verificó con el módulo SpeculationControl de PowerShell. Cuando cambiaron a otro modelo de CPU, x86-64-v3, esas mitigaciones dejaron de activarse de la misma forma.
La seguridad no desapareció, porque la capa del hipervisor seguía dando protección. Windows simplemente dejó de aplicar capas adicionales de mitigación que estaban ralentizando mucho las operaciones de memoria.
Un comentarista lo expresó de una forma con la que muchos administradores se identificaron: no había nada misterioso, solo la interacción entre Windows y las capacidades de hardware expuestas.
El coste invisible: la latencia de memoria se dispara
Los problemas de rendimiento suelen verse en las gráficas. Este se escondía entre los números.
Herramientas de monitoreo como Grafana no mostraban picos alarmantes. La CPU no estaba al máximo, el uso de RAM se mantenía estable y los paneles de rendimiento tradicionales daban a entender que todo funcionaba como se esperaba. Pero en cuanto cambió el modo de CPU, la diferencia fue evidente casi de inmediato. Los usuarios dejaron de quejarse, las sesiones remotas volvieron a responder bien y las aplicaciones se comportaron con normalidad.
Lo que cambió fue la latencia de memoria. En lugar de unos 100 nanosegundos por acceso, el sistema había estado sufriendo retrasos de unos 2000 nanosegundos con la configuración cargada de mitigaciones. Esa diferencia es enorme para cargas de trabajo que tocan la memoria constantemente.
Los entornos de Escritorio remoto son especialmente sensibles a estos retrasos. Muchas operaciones pequeñas, como las actualizaciones de la interfaz, la interacción con las aplicaciones y la gestión de sesiones, dependen de un acceso rápido a la memoria. Aunque el uso de CPU se mantenga bajo, la latencia a nivel de memoria puede lastrar toda la experiencia sin que nadie sepa por qué.
Curiosamente, los benchmarks tradicionales no captaban bien el problema. La experiencia diaria de los usuarios lo dejaba al descubierto mucho mejor que las pruebas sintéticas.
No todo el mundo está de acuerdo sobre la causa
Como pasa con muchos temas de infraestructura, el debate se dividió enseguida en varios puntos de vista.
Un grupo sostenía que el comportamiento es bien conocido y que la culpa es de Windows y no de Proxmox. El sistema operativo aplica las protecciones de seguridad de forma agresiva y ya no deja que los administradores las desactiven con facilidad cuando el hardware parece vulnerable. Los entornos Linux ofrecen más flexibilidad, y por eso el modo de CPU host suele rendir mejor allí.
Otra perspectiva se centraba en la antigüedad de la configuración. Algunos administradores decían que muchas de las guías que circulan hoy están desfasadas y recomiendan ajustes que tenían sentido hace años pero ya no reflejan la práctica actual de la virtualización. Para ellos, lo correcto es un enmascaramiento de CPU adecuado a la arquitectura del clúster, en lugar de elegir el modo host a ciegas.
Un tercer punto de vista señalaba que la gravedad depende mucho de la CPU física. Algunos procesadores incluyen correcciones por hardware para las vulnerabilidades que reducen o eliminan la necesidad de mitigaciones costosas, y en esos entornos el modo de CPU host puede que no provoque la misma ralentización drástica. Así que el problema no es universal, pero cuando aparece, puede ser devastador.
Hardware heredado, configuraciones heredadas y sorpresas de migración
Las configuraciones de virtualización heredadas añaden otra capa a la historia.
El entorno con la ralentización seguía usando el tipo de máquina i440fx con SeaBIOS, una configuración que aparece a menudo tras migrar desde instalaciones antiguas de VMware. Funciona, pero i440fx es una arquitectura PCI más antigua que la plataforma Q35, más moderna.
Varios ingenieros señalaron que i440fx puede convertirse en un cuello de botella cuando las cargas de trabajo dependen de dispositivos de gran ancho de banda como discos NVMe, redes de 10 gigabits o subsistemas USB 3.x. Q35, que usa PCIe internamente, se considera en general la base moderna para los despliegues nuevos.
Migrar a Q35 y al firmware OVMF ya estaba en la hoja de ruta del equipo que gestionaba el servidor afectado, pero el problema de configuración de la CPU salió a la luz antes de esa transición.
Cambiar el tipo de CPU tuvo otro efecto secundario: Windows mostraba a veces un genérico "QEMU Virtual CPU version 2.5+" en lugar del nombre real del procesador. Era sobre todo algo estético, pero mostraba cuánta abstracción hay entre el hardware físico y el entorno virtual, y cómo esas abstracciones se comportan a veces de formas sorprendentes.
La solución práctica: un modelo de CPU menos obvio
La solución final fue sorprendentemente sencilla. En lugar del modo de CPU host, el equipo cambió la máquina virtual al modelo de CPU x86-64-v3, que expone un conjunto de funciones de CPU moderno pero estandarizado en vez de reflejar el procesador exacto del host.
Ese cambio evitó que Windows activara las mismas mitigaciones de seguridad pesadas. La latencia de memoria cayó drásticamente y la experiencia de los usuarios mejoró casi al instante.
El modo de CPU host no siempre es malo. En algunos clústeres, sobre todo homogéneos y donde no hace falta migrar, puede seguir teniendo sentido. Pero dar por hecho sin más que es la opción más rápida puede llevar a sorpresas desagradables. En entornos con cargas de trabajo Windows, sobre todo servidores RDS u otras aplicaciones sensibles a la latencia, el modelo de CPU puede influir en el rendimiento de formas que no son evidentes a primera vista.
Un ajuste pequeño con grandes consecuencias
La virtualización está llena de ajustes que parecen menores hasta que dejan de serlo. La selección del tipo de CPU pasa desapercibida en los menús de configuración, a menudo sin tocar una vez creada la VM, y muchos administradores rara vez vuelven a revisarla tras el despliegue inicial. Aun así, este caso muestra hasta qué punto ese único parámetro puede determinar el comportamiento del sistema. Puede afectar a los flags de seguridad, activar mitigaciones del sistema operativo y multiplicar la latencia de memoria sin ningún aviso.
Lo peor es que la ralentización resultante puede no aparecer en los paneles de monitoreo. Aparece en cambio en lo que dicen las personas, en quejas vagas de usuarios que no saben explicar exactamente qué va mal, solo que el sistema va más lento de lo que debería.
Aquí, un simple cambio de modelo de CPU devolvió la agilidad sin añadir hardware ni reescribir aplicaciones. A veces la mayor mejora de rendimiento sale de darse cuenta de que la infraestructura que ya tienes sin querer juega en su contra.