

Por qué un clúster HA de tres nodos entra en pánico cuando caen dos nodos
La configuración que parece perfecta sobre el papel
Un clúster de virtualización pequeño puede parecer el punto ideal de fiabilidad: tres nodos, almacenamiento compartido por iSCSI o NFS y alta disponibilidad configurada para que las máquinas virtuales se muevan sin problemas entre hosts. El modo de mantenimiento funciona de maravilla. Pones un nodo en mantenimiento, arranca la migración en vivo, las cargas de trabajo se van a otro sitio y el host se reinicia tranquilamente.
The Hidden Proxmox CPU Setting That Could Break Your HA Cluster
Todo se comporta exactamente como se anuncia. Por eso la situación resulta tan desconcertante cuando un administrador prueba algo aparentemente inofensivo. Pone dos hosts en modo de mantenimiento, y todas las máquinas virtuales migran sin problemas al tercer nodo. Nada está sobrecargado, y el hardware tiene potencia de sobra para ejecutar todas las cargas de trabajo en una sola máquina.
Entonces los dos nodos en mantenimiento se reinician y, de repente, el último nodo empieza a comportarse como si algo hubiera ido terriblemente mal. Los servicios entran en pánico y a veces el host incluso se reinicia. Lo que parecía una ventana de mantenimiento rutinaria de pronto da la impresión de que el clúster se está defendiendo.
Para quien mira cómo desfilan los mensajes de error por la consola, la pregunta es inmediata y frustrante: ¿por qué el último nodo no puede seguir ejecutando las VMs sin más?
Salta la paranoia del clúster
La respuesta está en una regla que gobierna la mayoría de los clústeres de alta disponibilidad: el consenso por mayoría.
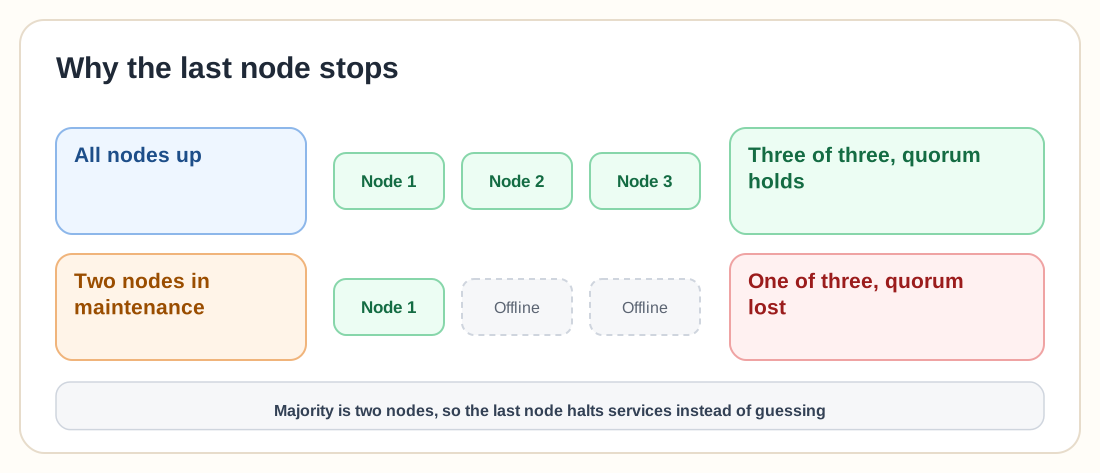
Los sistemas distribuidos no dan por hecho que entienden lo que pasa en la red. Dan por hecho lo contrario. Las redes fallan, los enlaces se caen, los switches tienen fallos puntuales y los paquetes desaparecen. Por esa incertidumbre, los clústeres dependen del quórum, es decir, de que una mayoría de nodos pueda confirmar que el estado del clúster es válido. En un clúster de tres nodos, esa mayoría son dos nodos.
En cuanto desaparecen dos nodos, el host que queda pierde el quórum. Desde el punto de vista del clúster, no sabe si las otras máquinas están realmente desconectadas o si es él el que ha quedado aislado del resto del sistema. Un ingeniero lo resumió sin rodeos: cuando desaparecen dos nodos, el último supone que el problema podría ser él.
Esa sospecha activa un comportamiento de protección. En lugar de seguir ejecutando cargas de trabajo a ciegas, el clúster detiene las operaciones para evitar algo mucho peor que el tiempo de inactividad.
El desastre que todos intentan evitar
El motivo de esta regla tan estricta es el split brain, que los ingenieros de clústeres temen más que casi cualquier otra cosa.
Imagina que el clúster permitiera al último nodo seguir ejecutando todas las VMs sin rechistar. Ahora imagina que el escenario original no fuera un reinicio planificado, sino una partición de red en la que un nodo pierde la conexión con los otros dos. Si el nodo aislado sigue ejecutando cargas de trabajo mientras los otros nodos lo dan por muerto, el clúster podría arrancar esas mismas máquinas virtuales en otro sitio, y existirían a la vez dos instancias idénticas de la misma VM.
Las bases de datos escriben datos contradictorios. Los sistemas de archivos se corrompen. Las transacciones divergen de formas casi imposibles de reparar después. Alguien describió el resultado como "dos de cada VM en marcha", lo que suele significar un día muy largo para quien mantenga la infraestructura.
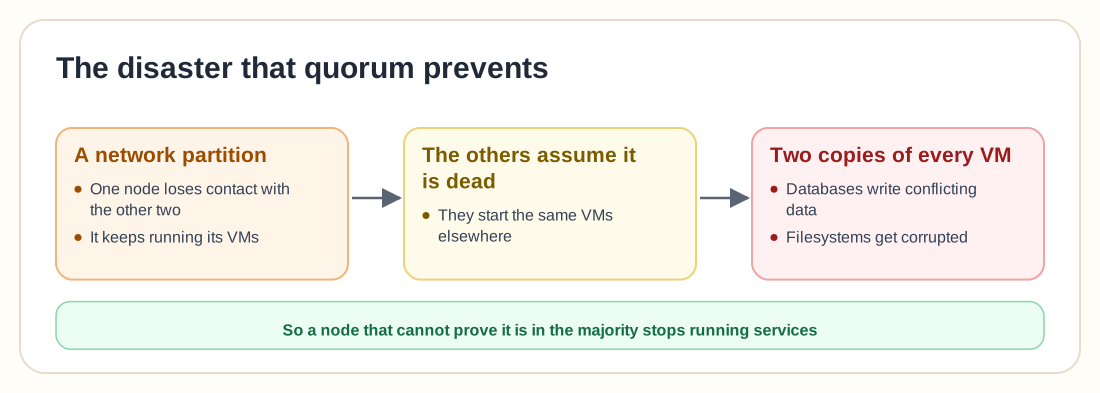
Para evitar ese escenario, el software de clúster sigue una regla conservadora: si un nodo no puede confirmar que pertenece a la mayoría, se niega a seguir ejecutando servicios, aunque el administrador sepa que la situación es segura.
El modo de mantenimiento no cambia las cuentas
A mucha gente le sorprende que el modo de mantenimiento no altere este comportamiento. Parece que debería hacerlo, porque poner nodos en modo de mantenimiento le dice claramente al clúster que esas máquinas salen a propósito del conjunto de cargas de trabajo.
Sin embargo, el modo de mantenimiento tiene que ver con la planificación y la migración. No anula el sistema de consenso que gobierna la seguridad del clúster. En cuanto dos nodos dejan de comunicarse, el host que queda sigue viendo una pérdida de quórum. A la lógica del clúster le da igual que los nodos se reiniciaran a propósito; simplemente observa que ha desaparecido la comunicación con la mayoría. Un sistema distribuido solo puede actuar según las señales que recibe, y no tiene forma de ver la intención.
La comparación con VMware que siempre sale
Cada vez que aparece esta situación, surgen enseguida las comparaciones con otras plataformas de virtualización.
Algunos administradores señalan el sistema de heartbeat de datastores de VMware. En ese modelo, los hosts pueden escribir información directamente en el almacenamiento compartido, lo que permite a otros nodos confirmar si una VM se está ejecutando de verdad en otro sitio. Ese enfoque da al clúster otra señal además de la comunicación por red.
Pero no es una solución universal. Cada plataforma toma decisiones de diseño distintas sobre cómo debe funcionar la seguridad del clúster. Algunas se apoyan mucho en las señales del almacenamiento, mientras que otras dan prioridad al consenso de red entre nodos.
Un comentario lo resumió con una lig