

Veeam en Windows Failover Cluster: copias que duplican el almacenamiento
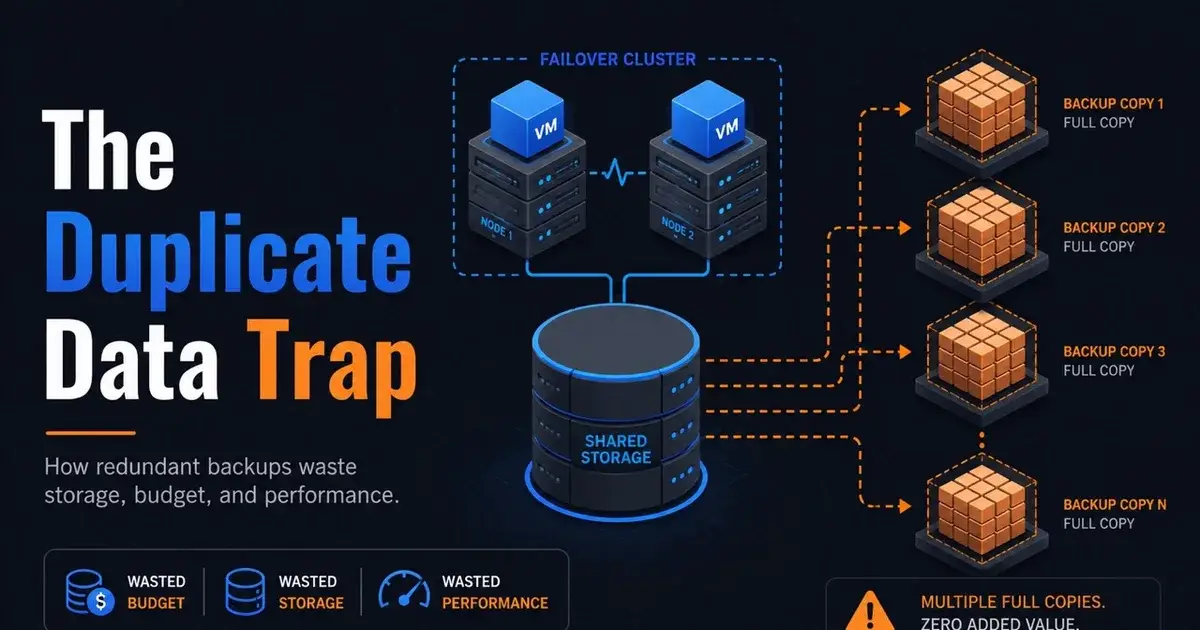
Los problemas de copia de seguridad en entornos en clúster se vuelven caros rápidamente cuando el almacenamiento compartido se replica como si cada nodo fuera dueño de una copia independiente. Un administrador de Veeam 12 describió exactamente ese comportamiento en 2026: las copias secundarias (backup copy) de Windows Failover Cluster no reconocían la estructura del clúster y duplicaban los datos compartidos en cada nodo.
Conviene analizar ese caso con prudencia, ya que refleja un entorno de producción concreto y un flujo de trabajo específico en Veeam 12. La documentación actual de Veeam 13, actualizada en julio de 2026, señala que las tareas de backup copy para copias de clúster con Veeam Agent generan un único archivo de copia por cada failover cluster. La distancia entre ambas situaciones demuestra por qué la versión y el método de protección escogido resultan decisivos.
¿Qué informó realmente el administrador de Veeam 12?
El entorno utilizaba Windows Failover Clusters, copias de seguridad en disco local, flujos de copia hacia S3 y cintas magnéticas. En medio de una queja más amplia sobre el almacenamiento en S3 y la atención del soporte técnico, el administrador detalló una limitación concreta de su clúster: con Veeam 12, sus tareas de Windows Failover Cluster no gestionaban bien las copias secundarias porque el proceso no reconocía el clúster y duplicaba el almacenamiento compartido para cada nodo.
La fuente original no detalla el número de nodos, la capacidad de los volúmenes compartidos, la compilación exacta de Veeam 12, la versión del agente, los parámetros de la tarea ni capturas del almacenamiento. Sin esos datos técnicos, no se puede generalizar el caso afirmando que "Veeam 12 siempre duplica los datos en clúster".
Lo que sí aporta esta experiencia es una advertencia práctica fundamental. Si una herramienta de copia de seguridad interpreta la pertenencia de un nodo de forma distinta a la propiedad de los datos compartidos, el consumo de espacio en el repositorio secundario puede dispararse muy por encima de lo planificado. Conviene detectar este comportamiento durante las pruebas de diseño, antes de acumular meses de retención.
¿Por qué es un problema tan grave duplicar el almacenamiento compartido?
El factor multiplicador puede resultar demoledor. Una copia única de un conjunto grande de datos en clúster puede ser perfectamente asumible, pero registrar ese mismo volumen una y otra vez por cada nodo del clúster satura el almacenamiento secundario y alarga enormemente las ventanas de copia.
La capacidad bruta es solo una parte de la factura. El exceso de datos genera mayor carga de entrada y salida en el repositorio, más operaciones sobre almacenamiento de objetos, más consumo en enlaces WAN, revisiones de integridad más lentas y procesos de retención más pesados. Si el destino de la copia secundaria es un almacenamiento en la nube tarificado por uso, el impacto en la factura resulta inmediato.
Incluso en centros de datos locales, duplicar datos lógicos puede obligar a comprar almacenamiento antes de tiempo y poner en peligro la sincronización de la recuperación ante desastres dentro de la ventana de tiempo requerida.
El centro de almacenamiento de Mr.PlanB resulta muy ilustrativo en este punto: la capacidad de backup debe proyectarse atendiendo al patrón de transferencia de datos y no solo al tamaño del volumen de origen. Un volumen compartido de 20 TB no se comporta económicamente como 20 TB si la tarea de protección lo escribe varias veces consecutivas.
¿Qué dice Veeam 13 sobre las copias de seguridad de clústeres de failover?
La documentación vigente de Veeam Backup & Replication 13 describe un flujo de trabajo dedicado para la protección de clústeres de failover mediante Veeam Agent for Microsoft Windows. Especifica asimismo que, al copiar esas copias de seguridad mediante backup copy, la tarea genera un único archivo de copia para todo el failover cluster.
El mismo manual técnico aclara que las tareas de clúster no generan archivos de copia individuales por máquina debido a las restricciones propias de este tipo de entornos. En esta modalidad, el clúster se gestiona como un único ámbito de protección unificado.
Ese comportamiento difiere sustancialmente de lo que el administrador experimentó en Veeam 12. Esto sugiere que cualquiera que revise este problema en 2026 debería comprobar primero si su versión y método de protección siguen presentando esa limitación antes de diseñar soluciones complejas para esquivarla.
Que "Veeam 12 se comportase así en un entorno" no demuestra que "Veeam 13 haga lo mismo hoy". De igual modo, tampoco conviene asumir que una simple actualización solucionará el problema sin realizar pruebas previas, porque el tipo exacto de tarea influye directamente.
¿Cómo comprobar el reconocimiento del clúster antes del despliegue?
Monta un clúster de prueba representativo con datos compartidos y ejecuta un ciclo de protección completo hacia un repositorio de evaluación. Registra el tamaño lógico de origen, el volumen del primer backup completo, el comportamiento de las copias incrementales y el tamaño final de la copia secundaria.
A continuación, añade un nodo adicional o transfiere el rol en clúster entre los distintos nodos, y vuelve a lanzar la copia de seguridad y la copia secundaria. El repositorio secundario evidenciará de inmediato si los datos compartidos se procesan una sola vez o si se replican por cada nodo.
Repite esta misma verificación tras cualquier actualización mayor de Veeam. Un producto puede cambiar la forma de descubrir, agrupar o copiar recursos en clúster entre versiones principales, por lo que una estimación de capacidad acertada para una entrega concreta puede volverse demasiado optimista o excesivamente prudente más adelante.
Para los equipos de virtualización que estudian cambios de plataforma más amplios, la guía de backup en Proxmox de Mr.PlanB insiste en una idea similar: el comportamiento de las copias de seguridad debe validarse directamente contra los objetos reales de la plataforma y no deducirse a partir del nombre comercial de una función.
¿Qué conviene medir más allá del tamaño del repositorio?
Mide la duración de la copia, el uso del enlace WAN, la granularidad de la restauración y qué ocurre si uno de los nodos deja de estar disponible. Un archivo de copia más ligero no es necesariamente mejor si complica la operativa de recuperación.
En un clúster de failover, prueba a recuperar tanto los datos compartidos como los nodos individuales siguiendo el procedimiento oficial. Confirma si los datos restaurados se reasignan correctamente a la estructura del clúster y cómo se gestionan los discos compartidos y los discos de testigo durante la recuperación.
La documentación actual de Veeam recoge particularidades para discos compartidos y testigos en disco, lo que refuerza la necesidad de verificar la restauración. El backup de un clúster no funciona como la copia de varios servidores aislados repetida en paralelo.
Comprueba también la política de retención. Si la tarea de backup copy aplica esquemas GFS de retención a largo plazo, cualquier problema de duplicación se multiplicará a lo largo de semanas, meses o años, y una única copia completa limpia no basta para validar un plan de capacidad anual.
¿Debería un equipo actualizar Veeam solo para resolver este problema?
Solo después de confirmar que la versión recomendada modifica exactamente el comportamiento que causa la anomalía. La documentación de Veeam 13 resulta prometedora para este modelo de copia secundaria en clústeres, pero una actualización de plataforma altera muchos otros componentes.
Revisa los repositorios, los servidores proxy, los agentes locales, las librerías de cintas, el almacenamiento de objetos, el cifrado, los scripts personalizados y el procesamiento con detección de aplicaciones antes de migrar el plano de control. Después, reproduce la prueba de copia en clúster en la versión de destino antes de dar el problema por cerrado.
Si la organización ya tiene prevista una migración hacia V13, este ensayo debe formar parte obligatoria de la fase de pruebas de aceptación. Si la versión V12 se mantiene estable y cuenta con soporte durante el plazo requerido, quizá baste con un ajuste menor de arquitectura según las características de cada carga.
La cuestión de fondo consiste en comprobar si el flujo oficial de V13 elimina la duplicación observada sin comprometer ningún otro requisito de recuperación.
¿Qué haría yo con un clúster que ya está duplicando datos?
En primer lugar cuantificaría el desfase. Compara la capacidad compartida real protegida en el clúster frente al volumen lógico ocupado en el repositorio secundario. Detecta qué puntos de restauración contienen datos repetidos y en qué medida las políticas de retención están amplificando el consumo.
Después configuraría esa misma tarea de protección en un entorno de laboratorio con Veeam 13 utilizando el flujo documentado para clústeres de failover, realizando pruebas completas de backup principal, copia secundaria, retención y restauración.
Si la versión moderna genera un único archivo por clúster tal y como indica la documentación y la restauración funciona limpiamente, la actualización ofrece una justificación económica evidente. Si la duplicación continúa porque la infraestructura utiliza un método de protección diferente, el siguiente paso consiste en rediseñar la tarea o abrir una incidencia técnica respaldada con esas mediciones.
El correcto reconocimiento de un clúster debe demostrarse observando cómo el software almacena y restaura los datos compartidos en la práctica.
Preguntas frecuentes
¿Duplicaba Veeam 12 el almacenamiento compartido del clúster en las copias de seguridad?
Un administrador informó en 2026 de que su flujo de backup copy en Windows Failover Cluster con Veeam 12 no reconocía el clúster y duplicaba el almacenamiento compartido en cada nodo. Se trata del reporte de un único entorno, no de una regla universal para todo clúster con Veeam 12.
¿Cómo documenta la versión actual de Veeam 13 las copias de clústeres de failover?
La documentación de Veeam 13 actualizada en julio de 2026 indica que una copia secundaria de backups creados con Veeam Agent para clústeres genera un único archivo de copia por cada failover cluster. Conviene contrastar este comportamiento frente al método de protección y la compilación exacta en uso.
¿Por qué puede resultar tan cara la duplicación en copias de seguridad de clústeres?
El almacenamiento compartido suele ser muy grande, por lo que tratar los mismos datos del clúster como contenidos independientes por cada nodo dispara el espacio en el repositorio, la duración de la copia, las operaciones en almacenamiento de objetos, el coste de retención y el tráfico de replicación.