

Deja de tocar cada dispositivo: canaliza traps SNMP hacia Zabbix a gran escala
Toda infraestructura en crecimiento llega a un punto de quiebre. Un día administras unas cuantas docenas de dispositivos y ajustarlos a mano no supone ningún problema. Al siguiente, te encuentras frente a cientos o miles de terminales físicos, y cada cambio de configuración parece como intentar vaciar el océano con una taza de café. En ese momento o automatizas o te ahogas.
La idea de enviar traps SNMP desde una única fuente centralizada hacia múltiples hosts de Zabbix ataca directamente ese dolor. En lugar de configurar cada dispositivo de forma individual para comunicarse con Zabbix, utilizas un servidor de gestión que ya se encuentra en el centro de tu entorno. Ya dispone de APIs y ya habla SNMP, así que ¿por qué no aprovecharlo para el trabajo pesado?
Todo el concepto está diseñado para escalar. Cuando gestionas cientos o miles de dispositivos, la configuración individual se convierte en el enemigo. Cada cambio manual introduce desvíos, cada actualización de firmware se arriesga a borrar los destinos de los traps y cada rediseño de red obliga a revisar incontables terminales. Centralizar el flujo de traps SNMP a través de una sola fuente corta ese caos de raíz.
Imagínatelo. En lugar de 1,000 dispositivos enviando traps directamente a tu servidor Zabbix, envían todo a una plataforma de gestión centralizada que agrega, procesa y reenvía los traps pertinentes. Desde la perspectiva de Zabbix, los traps proceden de un solo lugar, pero lógicamente pertenecen a muchos hosts diferentes.
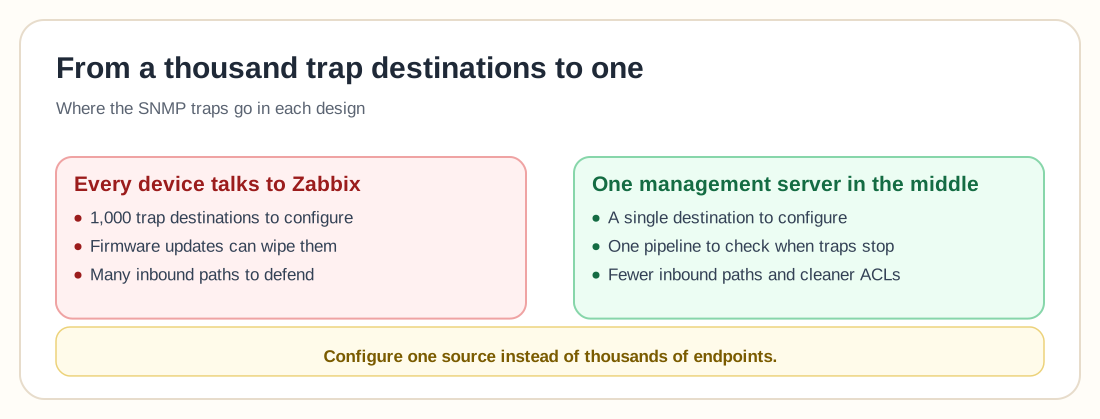
La mayor parte del trabajo se realiza en el diseño de las plantillas, y probablemente hagan falta dos plantillas en lugar de una, ya que separar responsabilidades mantiene todo limpio. Una plantilla gestiona la recepción y la lógica de preprocesamiento a nivel centralizado. La otra distribuye o asigna esos datos entrantes a los hosts de Zabbix correspondientes.
Esa separación parece sutil, pero resulta crítica. Si metes todo en una sola plantilla, se vuelve frágil con rapidez. Al aislar la capa de ingesta de traps de la capa de representación a nivel de host, creas una arquitectura modular, y los sistemas modulares sobreviven a los cambios.
Aquí es donde la cosa se pone interesante. Por naturaleza, a los traps SNMP no les importa la estructura de hosts de tu Zabbix; solo son paquetes con OIDs y cargas útiles. La parte difícil es asignar un trap recibido desde una única fuente al dispositivo lógico correcto dentro de Zabbix, y esa capa de mapeo es donde el diseño demuestra su valor.
Por lo general, hay algún identificador incrustado en el trap, como el ID del dispositivo, el número de serie, la IP o el hostname. El servidor centralizado ya lo entiende, y Zabbix también necesita entenderlo. Con un preprocesamiento adecuado, puedes extraer ese identificador y utilizarlo para enrutar el evento al host coincidente.
Esa es la diferencia entre una manguera caótica y una canalización estructurada de eventos. Sin lógica de análisis y enrutamiento, cada trap parece pertenecer al servidor de gestión. Con un preprocesamiento inteligente, el trap se convierte en un evento vinculado al dispositivo físico real que representa.
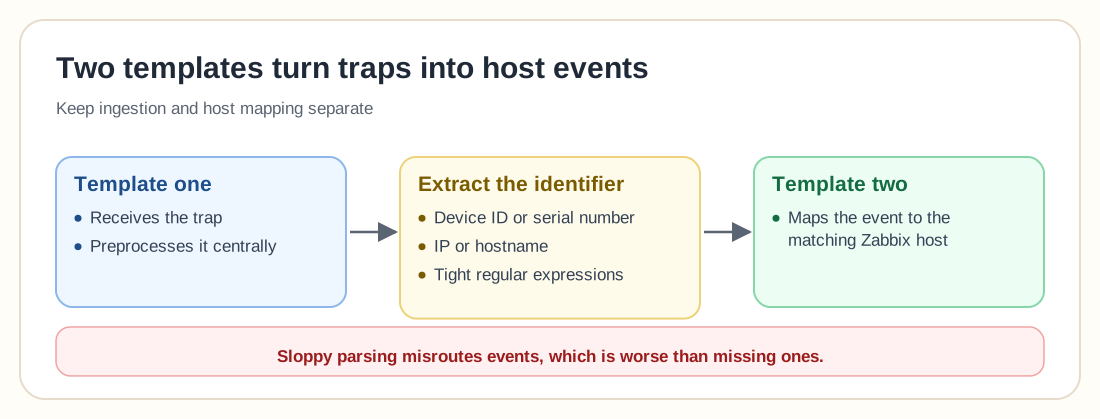
Aquí es también donde la escala deja de asustar. En lugar de configurar a mano los destinos SNMP en miles de terminales, configuras solo uno: el servidor centralizado. Cuando se incorporan nuevos dispositivos al entorno, se comunican con la capa de gestión. Zabbix no necesita conocerlos de forma individual a nivel de red; solo necesita reconocer sus identificadores.
Piensa un momento en las actualizaciones de firmware. Si alguna vez has aplicado actualizaciones en cientos de switches o sensores, sabes que la configuración de los traps a veces se restablece o requiere validación. Multiplica eso por miles y tienes una pesadilla de mantenimiento; la centralización elimina esa sobrecarga repetitiva.
También hay un ángulo de seguridad. Permitir que miles de dispositivos envíen traps directamente a tu servidor de monitoreo amplía tu superficie de exposición, complicando las reglas de firewall y la segmentación de red. Canalizar los traps a través de una sola fuente de gestión reduce ese perímetro, con menos rutas entrantes, ACLs más limpias y menos estrés durante las auditorías.
Este enfoque tampoco es magia directa lista para usar. El diseño de esas plantillas importa, y los pasos de preprocesamiento deben ser precisos. Las expresiones regulares tienen que ser lo bastante estrictas para extraer identificadores con fiabilidad, pero lo bastante flexibles para tolerar pequeñas diferencias de formato, ya que un análisis descuidado provoca eventos mal enrutados. Esos son peores que los que se pierden. Los eventos perdidos al menos resultan evidentes, mientras que los mal enrutados contaminan tus datos sin que nadie se dé cuenta.
La claridad operativa es la otra ventaja, menos visible pero igual de valiosa. Cuando centralizas la gestión de traps, la resolución de problemas se simplifica. Si los traps dejan de llegar, revisas un solo flujo en lugar de cientos de terminales. Si la asignación falla, depuras la lógica de la plantilla en lugar de rastrear las configuraciones de cada equipo.
El monitoreo pasa a centrarse en la arquitectura en lugar de en el dispositivo, lo que supone un auténtico cambio de mentalidad. En lugar de preguntarte "¿Configuré bien este dispositivo?", te preguntas "¿Está funcionando bien mi capa de ingesta de eventos?". Esa pregunta escala mucho mejor.
Hay un motivo por el que se insiste en que puedes recopilar datos de miles de dispositivos físicos con una plantilla sencilla, o tal vez dos. La palabra "sencilla" no es casual. La sencillez a gran escala significa menos piezas móviles, menos dependencias ocultas y menos lugares donde pueda colarse el desvío de configuración.
Por supuesto, existen compromisos. La centralización crea una dependencia respecto al servidor de gestión, y si este cae, el flujo de traps se detiene, por lo que la redundancia y la alta disponibilidad importan. Reubicas la complejidad en lugar de eliminarla. Sin embargo, trasladarla a un único sistema controlable suele ser una clara ventaja.
Luego está el factor humano. Los entornos grandes los mantienen equipos, y los equipos necesitan coherencia. Un enfoque basado en plantillas asegura que los nuevos hosts sigan la misma lógica que los antiguos, sin recurrir a conocimientos no documentados ni a excepciones del tipo "este se configuró de otra forma hace tres años", solo procesamiento estandarizado.
Esa coherencia se amortiza durante las auditorías o la respuesta a incidentes. Cuando alguien pregunta cómo se gestionan los traps en 5,000 dispositivos, no te quedas dudando. Señalas la arquitectura: una sola fuente, plantillas definidas y reglas de preprocesamiento documentadas.
En gran medida, esta estrategia consiste en sacar más provecho de la infraestructura que ya tienes: un servidor de gestión centralizado con capacidades de API y SNMP. En lugar de tratarlo como una herramienta más, lo conviertes en la columna vertebral de tu ingesta de monitoreo. Escalas por diseño y no por fuerza bruta.
Si administras un puñado de dispositivos, esto puede parecer un exceso de ingeniería. Una vez que superas los cientos, y sobre todo los miles, la configuración manual deja de ser sostenible, y la decisión más sensata es replantear el flujo de los datos. En monitoreo, el cuello de botella suele estar más en la arquitectura que en la CPU o el almacenamiento, y una vez que rediseñas cómo entran los traps a tu sistema, todo lo que viene después se vuelve más tranquilo, más limpio y mucho más predecible.