

Por qué Kubernetes aún no cuenta con migración en vivo nativa de contenedores
Kubernetes ha recorrido un largo camino en la orquestación de cargas de trabajo contenedorizadas, pero mantiene una omisión llamativa que resulta casi anacrónica en 2025: el soporte nativo para la migración en vivo de contenedores.
Cabría pensar que, con todos los avances en la tecnología de contenedores (abstracciones serverless, planificadores multinube, orquestación de GPU e incluso clústeres en el edge), mover un contenedor entre nodos sin destruirlo sería un requisito básico a estas alturas. No lo es, y para una plataforma diseñada en torno a la resiliencia y la escalabilidad, resulta cuando menos extraño.
CAST AI presentó recientemente una característica que aborda directamente este reto: Container Live Migration para EKS. Mediante CRIU (Checkpoint/Restore In Userspace), permite pausar un contenedor en ejecución, copiar su estado completo, incluyendo la memoria y la información de los procesos, y reanudarlo en otro nodo. Piensa en la «migración en vivo de máquinas virtuales», pero aplicada a contenedores. La reacción combinó asombro, escepticismo y bastante desconcierto a partes iguales.
Este artículo analiza qué es la migración en vivo de contenedores, por qué Kubernetes todavía no la soporta de forma nativa y por qué va siendo hora de que lo haga.
Primero, ¿qué es exactamente la migración en vivo de contenedores?
En términos sencillos, la migración en vivo significa trasladar un contenedor en ejecución de un nodo a otro sin detenerlo ni reiniciarlo.
Esto difiere radicalmente del funcionamiento actual de Kubernetes. Hoy en día, si necesitas reequilibrar tus cargas de trabajo (por ejemplo, por tareas de mantenimiento o para optimizar la densidad de recursos), el pod se destruye y se vuelve a crear en otra parte. Para aplicaciones sin estado (stateless), esto no supone un problema. Para cualquier sistema más complejo, la historia cambia por completo.
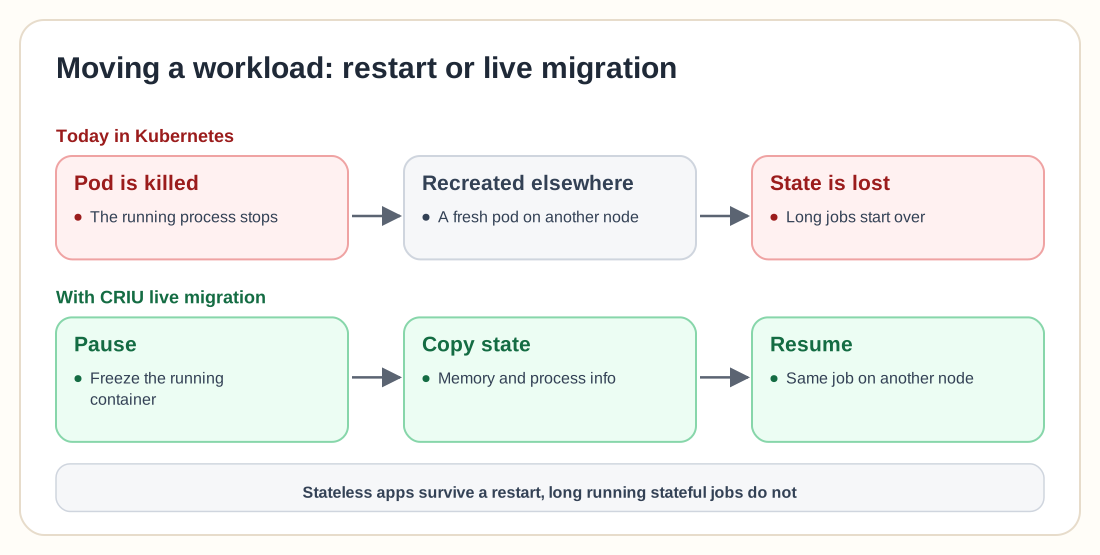
La migración en vivo permitiría:
- Mover un contenedor que procesa datos de larga duración a un nodo distinto sin reiniciar la tarea
- Desalojar pods de un nodo a punto de ser terminado (como una instancia spot) sin sufrir interrupciones
- Evitar tiempos de inactividad en cargas de trabajo con estado, como servidores de videojuegos o centralitas PBX
- Reducir costes consolidando cargas de trabajo con mayor eficiencia a lo largo del tiempo
La idea lleva décadas funcionando en el mundo de las máquinas virtuales. VMware la incluye y KubeVirt la admite para máquinas virtuales dentro de Kubernetes. Los contenedores, sin embargo, son un terreno diferente.
¿Por qué Kubernetes no la soporta todavía?
Existen varios motivos principales.
1. Raíces filosóficas
Kubernetes se diseñó bajo la premisa de que las cargas de trabajo deben ser efímeras y tolerantes a fallos. Los elementos no se parchean ni se trasladan: se sustituyen. Las aplicaciones están pensadas para soportar reinicios continuos. Es la clásica analogía de ganado frente a mascotas (cattle vs. pets).
Sin embargo, el panorama ha cambiado. Las cargas de trabajo con estado están presentes en todas partes, gracias a operadores más maduros, al soporte de volúmenes persistentes y a herramientas consolidadas como Longhorn y Rook. Hoy ejecutamos mucho más que Nginx y Redis: grandes procesos de Spark, inferencia de LLM, clústeres de PostgreSQL y servidores de videojuegos multijugador en tiempo real. La antigua premisa se está convirtiendo en un cuello de botella.
2. Es técnicamente difícil
Utilizar CRIU para generar un punto de control (checkpoint) y restaurar un contenedor parece sencillo sobre el papel. En la práctica, es un campo de minas.
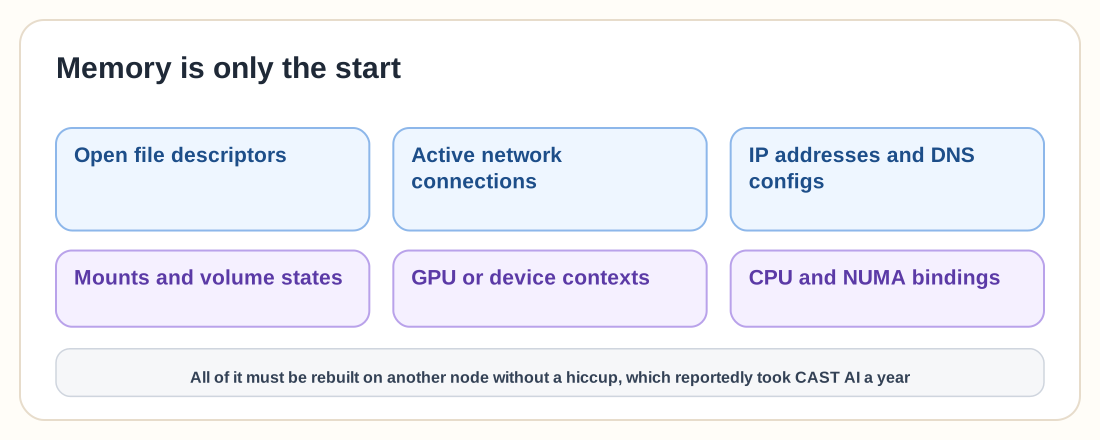
Guardar la memoria es solo el primer paso. También es imprescindible conservar:
- Descriptores de archivos abiertos
- Conexiones de red activas
- Direcciones IP y configuraciones DNS
- Montajes y estados de volúmenes
- Contextos de GPU o dispositivos dedicados (si existen)
- Asignaciones de afinidad a CPU y NUMA
Luego hay que reconstruir todo eso en otro nodo, idealmente dentro del mismo namespace, con la misma IP y en el mismo estado exacto, sin cortes perceptibles. No es una labor menor. Al parecer, a CAST AI le llevó un año completo desarrollar su versión, lo que da una idea de la complejidad técnica.
3. Kubernetes carece de primitivas nativas para ello
En la actualidad no existe ninguna API nativa en Kubernetes que permita ordenar «mueve este contenedor del nodo A al nodo B». El planificador trabaja a nivel de pod, no a nivel del estado interno del contenedor.
KubeVirt supera esta limitación ejecutando máquinas virtuales mediante un CRD (Custom Resource Definition) propio y, dado que las máquinas virtuales ya admiten migración en vivo a nivel de hipervisor, resulta más fácil construir por encima.
En el caso de los contenedores, Kubernetes necesitaría nuevas API, lógica de control específica y, posiblemente, cambios en cómo los runtimes de contenedores interactúan con el kubelet. No es imposible, pero dista mucho de ser trivial.
Por qué debería ser una función nativa
A pesar de todas las dificultades, las ventajas resultan demasiado evidentes para pasarlas por alto.
Mejor empaquetado de recursos (bin packing)
Hoy en día, si un nodo está infrautilizado, Kubernetes no puede reorganizar contenedores con agilidad para recuperar recursos. La única opción es destruir pods esperando que el planificador los ubique mejor la próxima vez. La migración en vivo facilitaría una optimización inteligente y no disruptiva de los recursos en tiempo real.
Supervivencia en instancias spot
En AWS, GCP y Azure, las máquinas virtuales spot o interrumpibles pueden desaparecer con un preaviso mínimo. La migración en vivo permitiría desplazar las cargas antes de que se apaguen los nodos. Eso se traduce en menos reinicios, menos errores y mayor disponibilidad, sobre todo en procesos de entrenamiento de IA donde los costes de reinicio son altísimos.
Soporte para cargas de trabajo de larga duración con estado
Algunos procesos simplemente no toleran bien los reinicios. Piensa en un trabajo de Spark que requiere 10 horas de ejecución pero solo utiliza el 50% de CPU la mayor parte del tiempo. Si pudieras desplazar partes de ese proceso sobre la marcha, ahorrarías recursos sin tener que reiniciar la tarea completa desde el principio, lo que supone un beneficio indiscutible.
Abrir paso a nuevos casos de uso
¿Quieres ejecutar un servidor de videojuegos en tiempo real sobre Kubernetes? ¿O un bot de negociación de alta frecuencia? ¿O una aplicación de conmutación telefónica? Tradicionalmente, todos estos escenarios han quedado fuera de la zona de confort de Kubernetes por su sensibilidad a los reinicios; la migración en vivo los integraría de forma natural.
¿Y ahora qué?
Hay indicios de que las cosas se mueven en esta dirección. La solución de CAST AI demuestra lo que ya es factible, aunque todavía no sea de código abierto. KubeVirt confirma que la migración en vivo puede funcionar en un entorno nativo de Kubernetes. Y el Grupo de Trabajo de Checkpoint/Restore dentro de la comunidad de Kubernetes investiga activamente cómo materializar estas ideas paso a paso.
Mientras tanto, proyectos como ZeroPod experimentan con la pausa y restauración de contenedores mediante CRIU para sistemas embebidos y en el edge. La semilla está plantada; la duda radica en si el núcleo de Kubernetes terminará asumiendo estas funciones de manera nativa. Probablemente debería hacerlo.
Kubernetes ha evolucionado mucho más allá de sus orígenes centrados en microservicios sin estado. Se ha convertido en el plano de control estándar de la infraestructura moderna, gestionando desde bases de datos hasta pipelines de aprendizaje automático. Las exigencias han cambiado, y la plataforma debe avanzar con ellas.
Reflexión final
La migración en vivo de contenedores es una pieza pendiente del puzle. A medida que las cargas de trabajo con estado pasan de ser la excepción a convertirse en la norma, Kubernetes necesitará actualizarse. El soporte nativo aportaría mayor resiliencia y abriría una categoría completamente nueva de casos de uso para los que Kubernetes nunca fue diseñado... hasta ahora.
Quizá la pregunta más oportuna sea cuánto tiempo más puede permitirse Kubernetes no soportar la migración en vivo.