

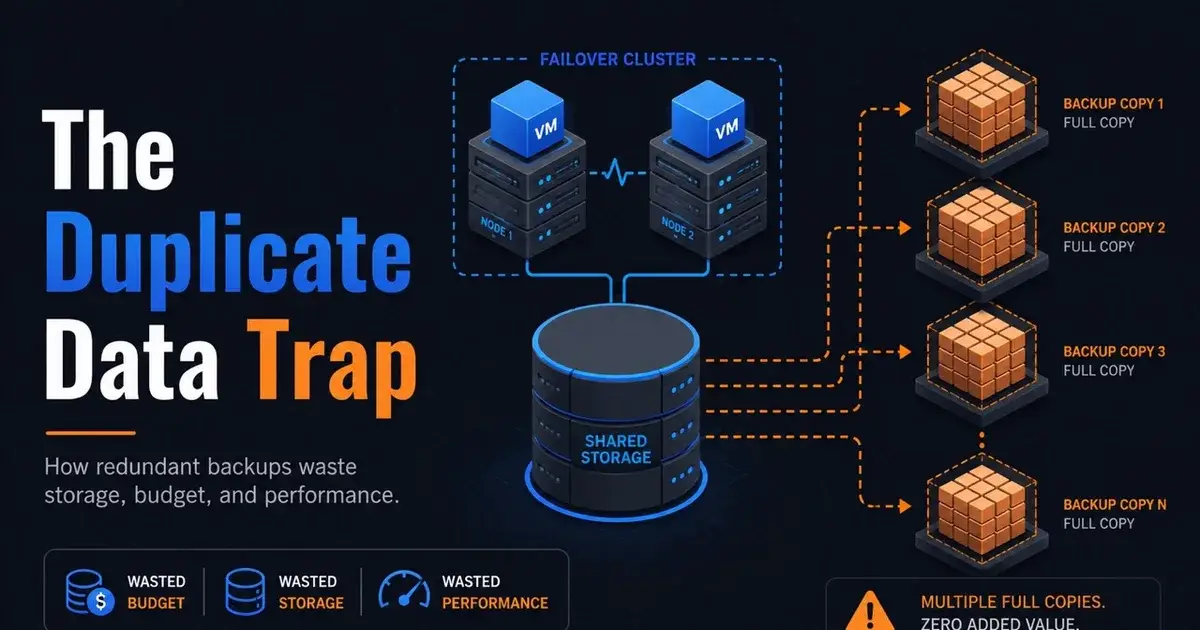
Veeam Failover-Cluster-Kopien: Die Falle doppelter Daten
Cluster-Backup-Probleme werden schnell teuer, wenn gemeinsam genutzter Speicher so kopiert wird, als hätte jeder Node eine eigene Kopie. Genau dieses Verhalten meldete 2026 ein Veeam-12-Administrator: Backup-Kopien des Windows Failover Cluster wurden als nicht cluster-aware beschrieben, wobei gemeinsam genutzter Speicher für jeden Node dupliziert wurde.
Diesen Bericht sollten Sie mit Vorsicht lesen, denn er beschreibt eine einzelne Produktivumgebung und einen Veeam-12-Workflow. Die im Juli 2026 aktualisierte aktuelle Veeam-13-Dokumentation besagt, dass die Backup-Kopie für Veeam-Agent-Failover-Cluster-Backups eine einzige Backup-Kopie-Datei pro Failover-Cluster erzeugt. Weil die beiden Aussagen so weit auseinanderliegen, kommt es auf Version und Schutzmethode an.
Was hat der Veeam-12-Administrator tatsächlich berichtet?
Die Umgebung nutzte Windows Failover Cluster, lokale Backups, S3-Kopier-Workflows und Tape. Inmitten einer umfassenderen Beschwerde über S3 und Support fügte der Administrator eine konkrete Cluster-Einschränkung hinzu: Unter Veeam 12 unterstützten die Windows-Failover-Cluster-Jobs Backup-Kopien nicht ordentlich, weil der Kopiervorgang nicht cluster-aware war und gemeinsam genutzten Speicher für jeden Node duplizierte.
Die Quelle nennt weder Cluster-Größe noch Kapazität des gemeinsam genutzten Volumes, den genauen Veeam-12-Build, die Agent-Version, die Job-Konfiguration noch einen Storage-Screenshot. Ohne diese Details lässt sich der Fall nicht zu „Veeam 12 dupliziert immer Cluster-Daten" verallgemeinern.
Als praktische Warnung taugt der Fall trotzdem. Wenn ein Schutzprodukt die Node-Zugehörigkeit anders sieht als die Eigentümerschaft gemeinsam genutzter Daten, kann die Backup-Kopie-Kapazität stark von dem abweichen, was der Administrator erwartet. Solches Verhalten sollte beim Design-Test auffallen und nicht erst nach Monaten angesammelter Aufbewahrung.
Warum ist die Duplizierung von gemeinsam genutztem Speicher so ein großes Problem?
Der Multiplikationsfaktor kann enorm sein. Ein großer Cluster-Datensatz, der einmal kopiert wird, mag akzeptabel sein. Derselbe Datensatz, der für jeden Cluster-Node erneut abgebildet wird, kann deutlich mehr sekundären Speicher verbrauchen und die Kopierfenster verlängern.
Dazu kommen Kosten über die reine Kapazität hinaus, denn zusätzliche Daten erzeugen mehr Repository-I/O, mehr Object-Storage-Operationen, mehr WAN-Traffic, längere Aufbewahrungsverarbeitung und längere Health-Checks. Wenn das Kopierziel abrechnungspflichtiger Cloud-Storage ist, kann sich auch die Rechnung ändern.
Selbst On-Premises können doppelte logische Daten frühere Storage-Anschaffungen erzwingen und die Synchronisation für die Disaster Recovery erschweren, innerhalb des geforderten Zeitfensters fertig zu werden.
Der Storage-Hub von Mr.PlanB ist hier relevant, weil Backup-Kapazität neben der Größe des Quellvolumes auch das Datenbewegungsmuster berücksichtigen muss. Ein gemeinsam genutzter 20-TB-Datensatz verhält sich wirtschaftlich nicht wie 20 TB, wenn der Schutz-Workflow ihn mehrfach schreibt.
Was sagt Veeam 13 zu Backup-Kopien von Failover-Clustern?
Die aktuelle Dokumentation von Veeam Backup & Replication 13 beschreibt einen eigenen Schutz-Workflow für Failover-Cluster mit Veeam Agent für Microsoft Windows. Sie besagt außerdem, dass beim Kopieren dieser Failover-Cluster-Backups der Backup-Copy-Job eine einzige Backup-Kopie-Datei pro Failover-Cluster erzeugt.
Dieselbe Dokumentation merkt an, dass Failover-Cluster-Jobs aufgrund von Cluster-Einschränkungen keine Backup-Dateien pro Maschine erzeugen. Stattdessen wird der Cluster für diese Backup-Methode als ein zusammenhängender Cluster-Scope behandelt.
Das unterscheidet sich deutlich von dem Verhalten, das der Administrator für Veeam 12 beschrieben hat. Es legt nahe, dass jeder, der das Problem 2026 bewertet, zuerst prüfen sollte, ob die genaue Version und Schutzmethode sich noch immer so verhalten, bevor er um die alte Einschränkung herum plant.
Dass „Veeam 12 das in einer Umgebung getan hat", beweist nicht, dass „Veeam 13 das jetzt tut". Ebenso wenig repariert ein Upgrade eine Umgebung ohne Test, denn es kommt auf den genauen Job-Typ an.
Wie testen Sie Cluster-Awareness vor dem Rollout?
Erstellen Sie einen repräsentativen Cluster mit gemeinsam genutzten Daten und führen Sie einen vollständigen Schutzzyklus in ein Test-Repository durch. Erfassen Sie die logische Quellgröße, die Größe des ersten vollständigen Backups, das Inkrement-Verhalten und die Größe der Backup-Kopie.
Fügen Sie dann einen Node hinzu oder verschieben Sie die geclusterte Rolle zwischen Nodes, und führen Sie Backup und Kopie erneut aus. Das sekundäre Repository sollte deutlich zeigen, ob gemeinsam genutzte Daten einmalig behandelt oder pro Node wiederholt werden.
Führen Sie denselben Test nach einem Veeam-Upgrade erneut durch. Ein Produkt kann zwischen Major Releases ändern, wie geclusterte Assets erkannt, gruppiert oder kopiert werden. Eine Kapazitätsplanung, die für eine Version korrekt war, kann später zu konservativ oder zu optimistisch werden.
Für Virtualisierungsteams, die größere Plattformwechsel prüfen, macht der Proxmox-Backup-Leitfaden von Mr.PlanB einen ähnlichen Punkt: Backup-Verhalten muss gegen die tatsächlich geschützten Plattformobjekte getestet werden, weil ein allgemeines Feature-Label wenig darüber aussagt.
Was sollten Sie neben der Repository-Größe noch messen?
Messen Sie Kopierdauer, WAN-Nutzung, Wiederherstellungsgranularität und was passiert, wenn ein Node nicht verfügbar ist. Ein kleineres Backup ist nicht automatisch besser, wenn der Restore-Workflow dadurch schwieriger wird.
Testen Sie bei einem Failover-Cluster die Wiederherstellung gemeinsam genutzter Daten und einzelner Nodes gemäß der unterstützten Methode. Prüfen Sie, ob wiederhergestellte Daten korrekt auf den Cluster zurückgeführt werden und wie Witness-Disks und gemeinsam genutzte Disks während der Wiederherstellung dargestellt werden.
Die aktuelle Veeam-Dokumentation beschreibt spezifisches Verhalten für gemeinsam genutzte Disks und Disk-Witnesses. Auch deshalb gehört der Restore-Test dazu, denn Cluster-Backup funktioniert anders als ein gewöhnliches Server-Backup, das mehrfach wiederholt wird.
Testen Sie außerdem die Aufbewahrung. Wenn ein Backup-Copy-Job langfristige GFS-Punkte verwendet, kann sich ein Duplizierungsproblem über viele wöchentliche, monatliche oder jährliche Wiederherstellungspunkte hinweg summieren. Ein einziges sauberes vollständiges Backup belegt deshalb noch kein Kapazitätsmodell für ein ganzes Jahr.
Sollte ein Team nur wegen dieses Problems auf Veeam upgraden?
Nur nachdem bestätigt wurde, dass die aktuelle unterstützte Version das genaue Verhalten ändert, das das Problem verursacht. Die Veeam-13-Dokumentation ist für das konkrete Backup-Copy-Modell von Failover-Clustern ermutigend, aber ein Upgrade ändert mehr als nur ein Feature.
Inventarisieren Sie Repositories, Proxys, Agents, Tape, Object-Storage, Verschlüsselung, Skripte und Application-Aware-Processing, bevor Sie die Control Plane verschieben. Reproduzieren Sie dann den Cluster-Kopiertest in der Zielversion, bevor Sie das Problem für gelöst erklären.
Wenn die Umgebung bereits eine V13-Migration plant, sollte dieser Test Teil der Abnahme sein. Wenn V12 stabil und für den erforderlichen Zeitraum unterstützt ist, ist je nach Workload möglicherweise eine kleinere Architekturänderung möglich.
Dass V13 neuer ist, reicht als Grund nicht. Zu klären ist: „Beseitigt der unterstützte V13-Workflow die gemessene Duplizierung, ohne eine andere Wiederherstellungsanforderung zu brechen?"
Was würde ich mit einem Cluster tun, der bereits Daten dupliziert?
Ich würde zuerst die Verschwendung quantifizieren. Vergleichen Sie die reale geschützte gemeinsam genutzte Kapazität des Clusters mit der logischen Kapazität, die in das sekundäre Repository geschrieben wird. Identifizieren Sie, welche Wiederherstellungspunkte wiederholte Daten enthalten und wie stark die Aufbewahrung diesen Effekt verstärkt.
Dann würde ich denselben Cluster-Schutz-Job in einer aktuellen Veeam-13-Testumgebung mit dem dokumentierten Failover-Cluster-Workflow nachbauen. Führen Sie primäres Backup, Backup-Kopie, Aufbewahrung und Restore-Tests durch.
Wenn die aktuelle Version wie dokumentiert eine Kopie auf Cluster-Ebene erzeugt und die Wiederherstellung funktioniert, hat das Upgrade einen messbaren Business Case. Bleibt die Duplizierung bestehen, weil die Produktivumgebung eine andere Schutzmethode verwendet, ist der nächste Schritt, das Job-Design zu ändern oder mit diesen Belegen einen gezielten Support-Fall zu eröffnen.
Ob ein Produkt cluster-aware ist, zeigt Ihnen keine Checkbox. Sie sehen es erst, wenn Sie beobachten, wie es gemeinsam genutzte Daten speichert und wiederherstellt.
Häufig gestellte Fragen
Hat Veeam 12 gemeinsam genutzten Cluster-Speicher in Backup-Kopien dupliziert?
Ein Administrator berichtete 2026, dass der Backup-Copy-Workflow für den Windows Failover Cluster unter Veeam 12 nicht cluster-aware war und gemeinsam genutzten Speicher für jeden Node dupliziert hat. Das ist ein Erfahrungsbericht aus einer einzelnen Umgebung und gilt nicht automatisch für jeden Veeam-12-Cluster.
Wie dokumentiert das aktuelle Veeam 13 Backup-Kopien von Failover-Clustern?
Laut der im Juli 2026 aktualisierten Veeam-13-Dokumentation erzeugt eine Backup-Kopie von Veeam-Agent-Failover-Cluster-Backups eine einzige Backup-Kopie-Datei pro Failover-Cluster. Prüfen Sie dieses Verhalten für die genaue Schutzmethode und den verwendeten Build.
Warum kann die Duplizierung von Cluster-Backups teuer werden?
Gemeinsam genutzter Speicher kann sehr groß sein. Werden dieselben Cluster-Daten als getrennter Inhalt pro Node behandelt, steigen Repository-Verbrauch, Kopierdauer, Object-Storage-Operationen, Aufbewahrungskosten und Replikationsverkehr.