

VAST Datas KI-OS stellt die Storage-Welt vor eine unangenehme Frage: echte Infrastruktur oder nur KI-Theater?
Es gibt eine besondere Art von Erschöpfung, die Infrastruktur-Leute überkommt, wenn wieder ein Anbieter hereinspaziert und die Worte „KI-ready“ sagt. Man kann den kollektiven Seufzer förmlich durch die Racktüren hören. Storage-Teams haben Cloud-First-Pitches überlebt, Software-defined-Alles, Hyperconverged-Umwege, Zero-Trust-Umbauten und genug „Single Pane of Glass“-Versprechen, um ein ganzes Rechenzentrum damit zu fliesen. Jetzt muss jedes Produkt zu einer KI-Plattform werden, jedes Dashboard braucht einen Agenten, und jede Roadmap klingt irgendwie, als hätte sie jemand umgeschrieben, der gerade erst an einer Konferenzbar Vektorsuche entdeckt hat.
Deshalb landete VAST Datas KI-OS-Pitch bei vielen Storage-Leuten mit einem so seltsamen Plumps. Die angekündigte Idee klingt gewaltig: KI-Agenten in der UI, verteilte Analytics, Vektorsuche, RAG-Workflows, Datendienste und eine einheitliche Plattform, die unter Enterprise-KI liegen soll. Viele Betreiber reagierten darauf aber vor allem verwirrt. Welches Problem löst das eigentlich? Ist das eine natürliche Erweiterung einer Hochleistungs-Storage-Plattform in den KI-Stack, oder ist es eine glänzende Hülle um Tools, die anderswo schon existieren?
Der Pitch klingt gewaltig, und genau deshalb wurden die Leute misstrauisch
Das erste Problem mit einer Plattform wie dieser ist, dass sie versucht, zu viel auf einmal zu erklären. Storage-Leute sind an klare Wertversprechen gewöhnt: schnelleres Lesen, niedrigere Latenz, bessere Metadatenverarbeitung, einfacheres Scale-out, stärkere Snapshots, günstigere Kapazität, bessere Zuverlässigkeit. Das sind konkrete Dinge. Man kann sie testen, darüber streiten und am Ende Zahlen in eine Tabelle packen. Aber sobald das Gespräch zu KI-Agenten, verteilten Analytics, Vektordatenbanken und Plattform-Orchestrierung springt, fängt das Ganze an, sich nebelig anzufühlen.
Ein skeptischer Betreiber fasste die Stimmung unverblümt zusammen: Es gebe „nichts Besonderes“ daran, wenn sich dieselben Bausteine auf Standardhardware mit kommerzieller oder Open-Source-Software zusammensetzen ließen. Das ist die tiefste Wunde in dieser Debatte. Wenn RAG, Vektorsuche und Analytics-Pipelines bereits in flexiblen Ökosystemen verfügbar sind, warum sollte dann irgendjemand diese Fähigkeiten eng an einen Storage-Anbieter binden wollen? Es geht dabei um Kosten und noch mehr um Kontrolle. Infrastruktur-Teams hassen Lock-in, während sich der umgebende Markt noch schnell bewegt.
Eine andere Stimme legte noch härter nach und bezeichnete das Ganze als KI-Hype, der Käufer glauben machen soll, sie bräuchten etwas, das sie gar nicht brauchen. Diese Meinung hat Substanz, weil viele Enterprise-KI-Projekte immer noch Experimente in Produktionskleidung sind. Viele Unternehmen trainieren keine riesigen Modelle. Sie nutzen bestehende Modelle, fügen Retrieval hinzu, räumen Dokumente auf und versuchen, Chatbots davon abzuhalten, sich Richtlinienantworten auszudenken. Für diese Teams kann ein großes KI-OS weniger nach Lösung klingen und mehr nach einer sehr teuren Antwort auf eine Frage, die sie noch gar nicht gestellt haben.
Die faire Verteidigung: Große Unternehmen haben wirklich hässliche KI-Klempnerprobleme
Man sollte die andere Seite trotzdem nicht als Marketing-Flausen abtun. Hinter den KI-Buzzwords versteckt sich ein echtes Infrastrukturproblem. Große Unternehmen brauchen mehr als eine Vektordatenbank und einen Chatbot: Datenzugriffskontrollen, Performance, Skalierung, Governance, Uptime, Auditierbarkeit, Team-übergreifende Koordination und einen Weg, damit KI-Systeme beim Beantworten von Nutzerfragen Berechtigungen respektieren. Gerade dieser letzte Punkt gehört zu den haarigsten Problemen in Enterprise-KI.
Ein Verteidiger der Plattform formulierte es so: schwer sei die Aufgabe, viel Infrastruktur über viele Teams hinweg aufzubauen und dabei Zugriff, Performance, Sicherheit und Verfügbarkeit unter Kontrolle zu halten, und nicht irgendein einzelnes Feature. Das ist ein deutlich stärkeres Argument als „KI-Agenten sind cool“. Demnach versucht VAST, einen unübersichtlichen Enterprise-KI-Stack in eine kontrollierte Datenplattform zusammenzufalten.
Das ist wichtig, weil echte Unternehmen nicht im Demoland leben. Eine Bank, ein Forschungslabor, ein Medienarchiv oder ein KI-Cloud-Anbieter kann Petabytes an Daten haben, verschiedene Nutzerklassen, regulatorischen Druck, GPU-Cluster und Teams, die sich kaum auf Namenskonventionen einigen können. In dieser Umgebung kann das Zusammenstückeln von fünf Open-Source-Diensten in der Hoffnung, dass das Sicherheitsmodell hält, zu einem karrierebeendenden Hobby werden. Das Versprechen einer einzigen Plattform ist verlockend, weil Komplexität echte Kosten hat.
Trotzdem funktioniert die Verteidigung nur, wenn die Plattform die Komplexität tatsächlich reduziert. Wenn sie die Komplexität einfach in eine proprietäre Box verschiebt, wird der Wert unklarer. Storage-Käufer zahlen durchaus für Integration. Sie wollen nur den Beweis, dass diese Integration mehr Schmerz erspart, als sie erzeugt.
Das Lock-in-Argument ist keine Paranoia
Infrastruktur-Leute werden zynisch genannt, aber ein Großteil dieses Zynismus ist verdient. Sie haben erlebt, wie Anbieter offene Ideen in geschlossene Ökosysteme verwandelten und dann für immer Miete kassierten, wie „einheitliche“ Plattformen zu Upgrade-Fallen wurden und wie Tools, die zum Kaufzeitpunkt praktisch wirkten, drei Jahre später zu unbequemen Abhängigkeiten geworden sind.
Deshalb trifft die Lock-in-Kritik rund um RAG und Vektorsuche so hart. Diese Technologien stecken noch in den Kinderschuhen. Der beste Stack von heute ist vielleicht nicht der beste Stack im nächsten Jahr. Modellwahlen, Embedding-Strategien und Retrieval-Muster verschieben sich, und Sicherheits- und Observability-Praktiken holen erst auf. In dieser Art von Markt kann es riskant wirken, zu viel von der eigenen KI-Architektur an eine einzige Storage-Plattform zu binden.
Ein Lager sieht VASTs KI-OS im Grunde als Rube-Goldberg-Maschine: ein kompliziertes System, gebaut, um etwas Einfaches raffiniert aussehen zu lassen. Ein anderes liest es als Bewertungstheater und verweist auf die Idee, dass KI-nahe Infrastrukturunternehmen davon besessen werden können, größer zu wirken als der Storage-Markt, aus dem sie kommen. Die zynische Version geht so: „KI“ an die Story hängen, den adressierbaren Gesamtmarkt erweitern, über Agenten und Analytics reden und die Kurve nach oben treiben. Das ist hart, aber 2025 kann niemand mehr so tun, als käme dieser Verdacht aus dem Nichts.
Die klügere Version der Kritik ist weniger emotional. Sie sagt, Unternehmen sollten Schichten trennen, sofern es keinen klaren Grund gibt, es anders zu machen. Storage exzellent halten, Compute flexibel, KI-Dienste portabel, Vektorsuche austauschbar, und nichts zusammenschweißen, solange der operative Gewinn nicht offensichtlich ist. Mit Innovationsfeindlichkeit hat das wenig zu tun. Die Leute haben schlicht erlebt, was Lock-in sie später kostet.
Der VMware-Vergleich schneidet in beide Richtungen
Eines der interessanteren Argumente kam von jemandem, der zugab, nicht tief genug im Thema zu stecken, um den Bedarf sofort zu beurteilen. Er verglich die Verwirrung mit den frühen Reaktionen auf VMware oder Container. Am Anfang wirkten diese Technologien wie zusätzliche Komplexität. Warum eine Abstraktionsebene hinzufügen, wenn die Hardware schon existiert? Jahre später wurde Virtualisierung Standardinfrastruktur, und Container veränderten, wie Software deployt wird. Vielleicht durchlaufen KI-Infrastrukturplattformen dieselbe unbeholfene Phase.
Das ist ein fairer Punkt. Manche der wichtigsten Enterprise-Technologien wirkten seltsam, bevor ihre Anwendungsfälle offensichtlich wurden. Betreiber, die mit den Problemen von gestern beschäftigt waren, erkannten die Abstraktionen von morgen nicht immer sofort. Container waren zum Beispiel deutlich mehr als „winzige VMs“. Sie veränderten Packaging, Skalierung, Deployment-Geschwindigkeit und Service-Isolation. Sobald Teams das verstanden, klickte der Wert.
Vielleicht versucht VAST denselben Sprung: von einem Storage-System zu einer Daten-Betriebsschicht für KI. Wenn KI-Workloads wirklich zentral für den Unternehmensbetrieb werden, sieht die gewinnende Infrastruktur am Ende womöglich nach tief integrierten Daten-, Metadaten-, Such-, Sicherheits- und compute-nahen Diensten aus und weniger nach traditionellem Storage plus ein paar externen Diensten.
Allerdings gewannen VMware und Container, weil sie Schmerz lösten, den Leute irgendwann jeden Tag spüren konnten. Sie veränderten den Betrieb, statt es beim Slogan zu lassen. VAST muss dieselbe Messlatte reißen, und es reicht nicht, dass „KI-OS“ unausweichlich klingt: es muss langweilig nützlich werden. Das ist der schwierigste Übergang in der Enterprise-Tech, von aufregendem Pitch zu langweiliger Notwendigkeit.
Brauchen die meisten Unternehmen wirklich so viel Maschinerie?
Ein Großteil der Gegenreaktion läuft auf Skalierung hinaus. Das Argument der Skeptiker ist einfach: Die meisten Organisationen brauchen keine massive KI-Infrastruktur. Sie können bestehende Modelle nutzen, RAG für enge Anwendungsfälle hinzufügen und den Datenfußabdruck überschaubar halten. Ein Kommentator argumentierte, fast keine Organisationen bräuchten großskaliges LLM-Training, und RAG für definierte Anwendungsfälle brauche keine riesigen Storage-Ressourcen. Ein anderer sagte, Anbieter tauchten immer wieder auf und bestünden darauf, dass alles auf KI-ready aufgerüstet werden müsse, selbst wenn der Business Case für On-Prem-GPU-Investitionen noch gar nicht besteht.
Das landet, weil Enterprise-KI ungleichmäßig verteilt ist. Ein paar Organisationen brauchen wirklich massive KI-Infrastruktur. KI-Cloud-Anbieter, HPC-Zentren, globale Banken, Life-Sciences-Unternehmen und forschungsintensive Firmen können brutale Daten- und Performance-Probleme haben. Für sie könnte eine einheitliche Hochleistungs-Datenschicht attraktiv sein, weil ihre Systeme über ernsthafte Datengravitation hinweg laufen müssen und weit über einen Chatbot in der Ecke hinausgehen.
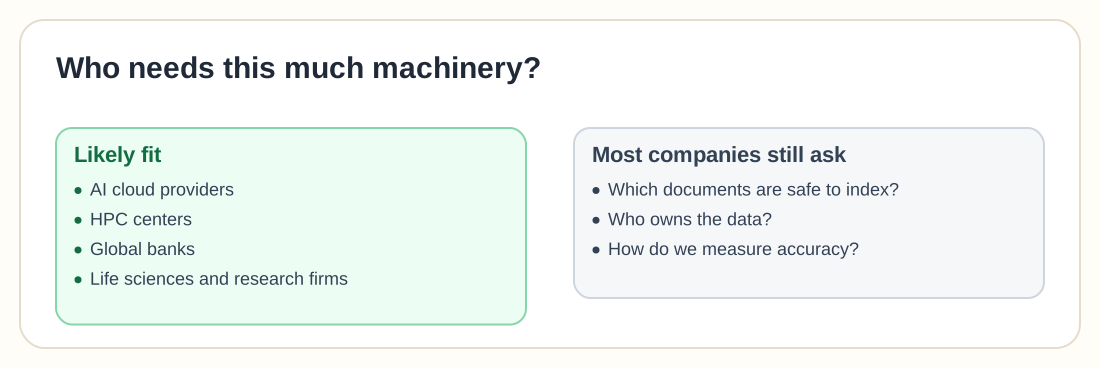
Die meisten Unternehmen gehören nicht in diese Gruppe. Sie versuchen noch, grundlegende Fragen zu beantworten. Welche Dokumente sind sicher zu indexieren? Wem gehören die Daten? Was passiert, wenn ein Mitarbeiter das Modell etwas fragt, das er nicht wissen sollte? Wie messen wir Genauigkeit? Wie vermeiden wir, dass vertrauliche Informationen in Tools durchsickern, die wir kaum kontrollieren? Das sind echte Probleme, aber sie erfordern nicht automatisch den Kauf einer riesigen KI-Plattform von einem Storage-Anbieter.
Genau hier muss VASTs Botschaft schärfer werden. Ist das für das durchschnittliche Unternehmen, das gerade mit RAG anfängt? Ist es für KI-Cloud-Bauer? Ist es für Organisationen, die in unstrukturierten Daten ertrinken? Ist es für sicherheitsbewusste KI-Deployments? Wenn die Antwort „alles davon“ lautet, werden Käufer hören: „Nichts davon ist klar.“
Beide Seiten könnten recht haben
Diese Debatte ist hitzig, weil beide Lager einen Punkt haben. Die Skeptiker haben recht, dass KI-Washing überall ist, dass viele Anbieter ihre Story dehnen, um Budgets hinterherzujagen, dass Open-Source- und Standard-Optionen existieren und dass Lock-in gefährlich ist, solange sich der KI-Stack noch formt. Und sie haben recht damit, zu fragen, welches Problem gelöst wird, bevor man in ein weiteres Plattformversprechen investiert.
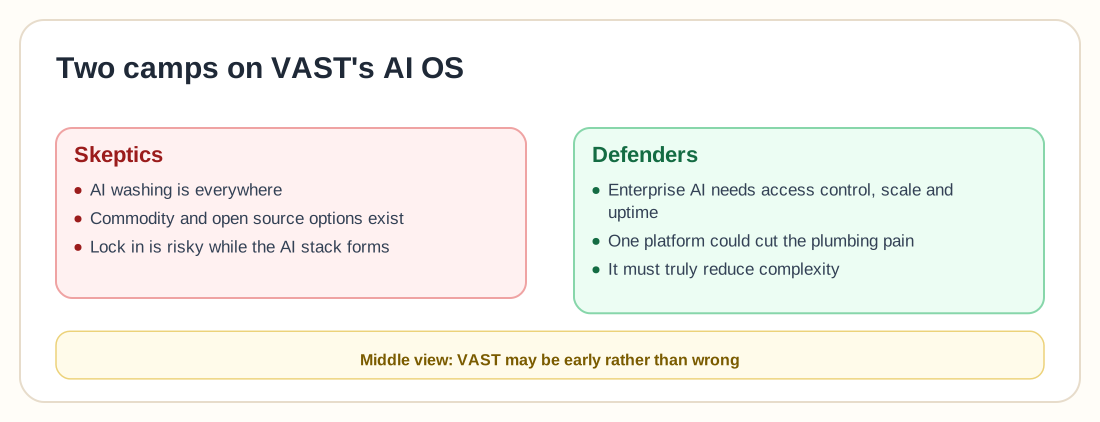
Die Verteidiger haben auch recht, dass ernsthafte Enterprise-KI mehr ist als eine Wochenend-RAG-Demo. Sicherheitsgrenzen, Datenlokalität, Metadaten, Skalierung, Uptime und Performance sind schwer. Je größer die Organisation, desto schmerzhafter wird diese Klempnerarbeit. Eine einzige Plattform, die diese Teile sauber handhabt, könnte echten operativen Ärger ersparen. Das ist handfeste Infrastrukturarbeit.
Die dritte Sichtweise ist wahrscheinlich die nützlichste: VAST ist vielleicht einfach zu früh dran. Die Plattform könnte für den Stand des durchschnittlichen Unternehmens heute übervermarktet sein und gleichzeitig für die kleine Gruppe von Kunden relevant bleiben, die schon in den KI-Datenproblemen von morgen leben. Das würde die Diskrepanz erklären. Storage-Betreiber, die auf normale Unternehmensbedürfnisse schauen, sehen Hype. KI-Infrastruktur-Teams, die mit Skalierung zu tun haben, sehen vielleicht eine Kontrollebene, die sie tatsächlich wollen.
Die Gefahr für VAST ist, dass Enterprise-Käufer fein justierte Unsinn-Detektoren haben. Wenn sich der Pitch anhört wie „kauf das, weil KI“, wird er verspottet. Wenn er sich anhört wie „so halten wir Berechtigungen, Suche, Performance, Analytics und Datenbewegung im massiven Maßstab vernünftig“, hat er eine Kampfchance. Mit ehrgeizigen Plattformen hat die Storage-Welt kein Problem, solange klar ist, was sie lösen. Genau diese Klarheit fehlt VAST Datas KI-OS im Moment noch.