

Proxmox im Unternehmenseinsatz: Die Fallstricke, die VMware-Admins nicht kommen sehen
Wenn VMware-Admins über den Sprung zu Proxmox sprechen, beginnt das Gespräch immer gleich: Die Broadcom-Rechnung landet im Postfach, jemand im Finanzteam gerät in Panik, und plötzlich wird der Virtualisierungs-Stack, der seit einem Jahrzehnt ruhig vor sich hin lief, zu einem dringenden Problem. Diese Geschichte ist mittlerweile praktisch ein eigenes Genre.
Ist Proxmox wirklich das günstige VMware-Fluchttor, für das Sie es halten?
Interessant wird es danach, wenn ein Team tatsächlich einen Proxmox-Proof-of-Concept aufsetzt und anfängt, seine alten ESXi-Gewohnheiten abzulegen. Dann tauchen nämlich die Fallstricke auf.
Teams, die diesen Weg schon hinter sich haben, sagen meist dasselbe: Schwierig ist weniger die Migration als die Denkweise. Je mehr jemand Proxmox wie ein VMware mit anderem Logo behandelt, desto mehr wackelt es.
Hier folgt eine Sammlung von Praxiserfahrungen, Warnungen und leicht genervten Ratschlägen von Engineers, die den Umstieg durchlebt haben, dazu die Überraschungen, die VMware-Veteranen immer wieder auf dem falschen Fuß erwischen.
Nicht migrieren, sagen die Profis, sondern neu aufbauen
Mehrere Engineers, die das in großem Maßstab gemacht haben, warnen: Wer das Projekt als reine Migration betrachtet, hat sich damit schon selbst eingeschränkt. Ein Admin brachte es unverblümt auf den Punkt: „Vergesst den Begriff Migration. Denkt in Redesign und Neuimplementierung."
Das hat handfeste Gründe. Die beiden Plattformen gehen Storage, Treiber, Netzwerk, CPU-Darstellung und Clustering mit gerade so vielen Unterschieden an, dass sich ein 1:1-Mapping zunächst natürlich anfühlt, bis es einem um die Ohren fliegt.
Teams, die ihr altes VMware-Layout in Proxmox nachbauen, reißen deshalb oft einen Monat später die Hälfte ihrer Arbeit wieder ein. Wer es als kompletten Neuaufbau angeht und sich auf sauberes Storage-Design, Netzwerksegmentierung und Node-Planung konzentriert, hat es in der Regel deutlich leichter.
Beim Storage sterben die VMware-Gewohnheiten
Ein Admin fasste es mit einem trockenen Lächeln zusammen: „VMFS hat uns verwöhnt."
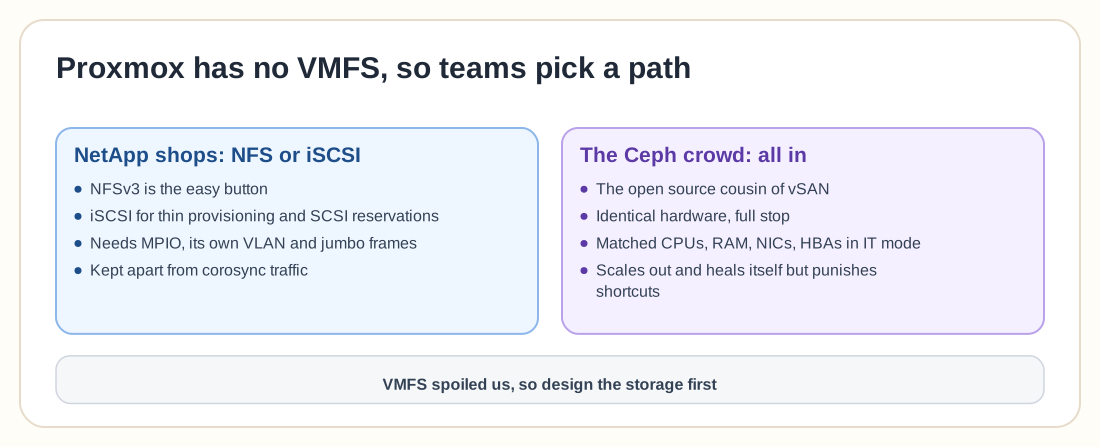
Unter VMware erledigt VMFS Snapshots, Reservierungen und Cluster-Verhalten fast unheimlich reibungslos. Proxmox nutzt aber kein VMFS, und das ist der erste große Schock.
Die meisten Teams landen auf einem von zwei Wegen.
1. NetApp-Betriebe bleiben bei NFS oder iSCSI
In Umgebungen, die ohnehin fest mit NetApp verheiratet sind, ist NFSv3 der einfache Ausweg: schnell, vertraut und simpel. iSCSI funktioniert auch, besonders wenn jemand Thin Provisioning und SCSI-Reservierungen braucht. Dafür gibt es eine Checkliste mit korrekt konfiguriertem MPIO, Storage im eigenen VLAN, Jumbo Frames und sauberer Trennung vom Corosync-Traffic.
Ein Engineer wies darauf hin, dass NetApp Proxmox inzwischen offiziell unterstützt, womit sich das jahrelange Händeringen à la „ist das überhaupt erlaubt?" erledigt hat.
2. Die Ceph-Fraktion geht all-in
Andere gehen den entgegengesetzten Weg und bauen komplette interne Storage-Arrays mit Ceph. Sie beschreiben es als Open-Source-Cousin von vSAN, der transparenter ist, aber deutlich empfindlicher auf schlampige Hardware-Entscheidungen reagiert.
Jeder Engineer, der mit Ceph zufrieden ist, sagt dasselbe: „Identische Hardware. Punkt." Gemeint sind passende CPUs, RAM, NICs und HBAs im IT-Modus, dazu Firmware im Gleichschritt.
Heraus kommt ein Storage-Fabric, das skalieren und sich selbst heilen kann, Abkürzungen aber bestraft. Die einzigen echten Ausfälle, die man dann überhaupt noch sieht, sind schlechter Arbeitsspeicher oder sterbende SSDs.
NUMA auf AMD Epyc: der Fallstrick, mit dem fast niemand rechnet
VMware-Admins wissen meist, wie man vNUMA auf Epyc-Hardware tunt. ESXi bietet Stellschrauben, um die NUMA-Topologie offenzulegen und Grenzen so anzupassen, dass sich Workloads benehmen.
Die KVM-Schicht von Proxmox hat diese Stellschrauben nicht, zumindest nicht in derselben Granularität, und genau hier werden Teams kalt erwischt.
Ein Engineer erklärte es schlicht: Intel-Sockel verhalten sich vorhersehbar, das Micro-NUMA-Layout von AMD Epyc berücksichtigt KVM dagegen bis heute nicht vollständig. Erstrecken sich die vCPUs einer VM über NUMA-Grenzen, taucht seltsame Latenz auf. Das ist nicht katastrophal, nur nervig, es sei denn, Sie betreiben Oracle, dann wird es zum Köder für Audits.
Als Workaround installiert man hwloc, numactl und ein Monitoring-Tool, das auf jedem Node CPU-Verzögerungen pro Thread offenlegt. Glamourös ist das nicht, aber nur so erkennt man, welche Workloads NUMA-Grenzen überschreiten und sich dabei unbemerkt selbst ausbremsen.
Windows-VMs verhalten sich anders, und die Lizenzierung wird chaotisch
Jeder Engineer, der Windows-Workloads migriert hat, warnt: Erwarten Sie nicht, dass Ihre alten Hardware-IDs, GUIDs oder PCI-Subsystem-IDs den Umzug überleben.
VMware präsentiert ein virtuelles Universum, KVM ein anderes. Beim Wechsel wird alles zurückgesetzt, woran Windows die Lizenzierung festmacht. In manchen Fällen heißt das, bei Microsoft anzurufen, gegen CSP-Beschränkungen zu kämpfen und sich für alles unter dem großen roten Schirm mit Oracle-Reauth herumzuschlagen.
Die meisten Admins empfehlen, jeden Lizenztyp früh an jeweils zwei Maschinen zu testen, bevor Sie offiziell eine Migrationswelle einplanen. Das ist mühsam, erspart Ihnen aber den Zusammenbruch um 2 Uhr morgens nach dem Motto „warum ist die Payroll-VM unlizenziert?".
Auch der Wechsel der Windows-Treiber folgt einer eigenen Choreografie:
- VMware Tools entfernen
- Neu starten
- VirtIO-Treiber installieren
- Erneut neu starten
- Den Import starten
- Die Boot-Disk als SATA anhängen
- Eine winzige SCSI-Disk mit VirtIO hinzufügen
- Booten und den Red-Hat-SCSI-Controller erkennen lassen
- Herunterfahren, die winzige Disk entfernen
- Die echte Boot-Disk wieder als SCSI anhängen
Das klingt absurd, bis man es einmal gemacht hat, danach macht es klick. Und ja, rechnen Sie beim ersten Boot mit einem BSOD. Beim zweiten Neustart korrigiert sich das System normalerweise von selbst.
Netzwerke verhalten sich anders, und Open vSwitch wird Ihr neuer Freund
Den Netzwerk-Stack von VMware mögen viele, weil er vorhersehbare Dinge auf vorhersehbare Weise tut. Die Linux-Bridge von Proxmox funktioniert einwandfrei, doch wer saubereres VLAN-Trunking, flexiblere Topologien oder ein Gefühl näher an ESXi will, wechselt fast immer zu Open vSwitch.
Danach fühle sich das VLAN-Mapping natürlicher an, und Automatisierungsschichten (Ansible, Terraform) verhielten sich konsistenter, berichten die Engineers.
Dazu kommt der Rat, den man immer wieder hört:
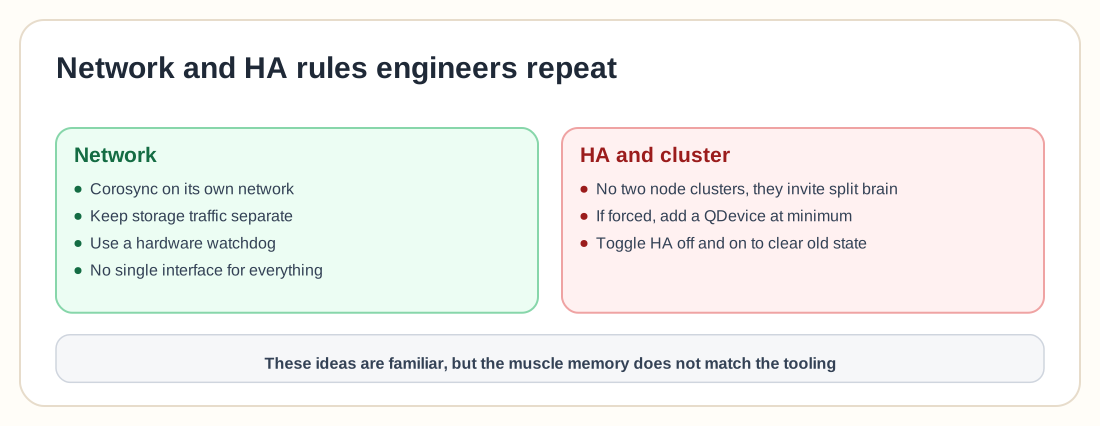
- Corosync in ein eigenes Netzwerk legen
- Storage-Traffic getrennt halten
- Einen Hardware-Watchdog verwenden
- Nicht alles „nur zum Testen" auf ein Interface packen und es dann vergessen
VMware-Admins kennen diese Ideen längst, nur passt das Muskelgedächtnis nicht immer zum neuen Tooling.
HA- und Cluster-Verhalten erfordern Umdenken
VMware HA wurde über Jahre so poliert, dass man es kaum noch bemerkt. Der HA-Stack von Proxmox funktioniert gut, verhält sich aber linuxartiger und transparenter. Diese Transparenz ist großartig, solange man sie nicht ignoriert.
Ein Team berichtete, dass bei sehr vielen VMs unter HA Backfill-Probleme auftreten können. Manchmal muss man HA deaktivieren und wieder aktivieren, damit alter Zustand verschwindet. Das ist selten, kommt aber wirklich vor.
Ein weiteres wiederkehrendes Thema: Betreiben Sie keine Zwei-Node-Cluster, damit fordern Sie ein Split-Brain förmlich heraus. Besteht die Führungsebene unbedingt darauf, sollte man laut den Engineers mindestens ein QDevice hinzufügen.
Mehr Eigenarbeit, aber weniger echte Probleme
Für VMware-Admins ist das vielleicht der größte Kulturschock.
Mehrere Engineers, die Proxmox seit Jahren betreiben, sagen, sie hätten praktisch nie ein Support-Ticket eröffnet. Hilfe hätten sie durchaus mal gebraucht, aber auf Plattformebene ging einfach nichts kaputt. Jeder Ausfall, den sie beschrieben, war Hardware: eine tote SSD, ein durchgebranntes DIMM, ein Stromproblem. Komponente tauschen, ZFS oder Ceph neu aufbauen lassen, weitermachen.
Handarbeit braucht Proxmox trotzdem. Kernel-Updates erfordern Neustarts, und Cluster-Upgrades wollen geplant sein. Die „mysteriösen Ausfälle", die man von ESXi-Host-Agenten oder vCenter-Eigenheiten kennt, gibt es in dieser Umgebung aber nicht.
Automatisierung hilft, nur das Ökosystem ist ein anderes
VMware-Admins haben oft vRealize oder PowerCLI im Blut. Proxmox setzt stark auf offenes Tooling:
- Ansible für Konfiguration
- Terraform für Provisionierung
- REST-API für individuelle Workflows
- Proxmox Backup Server für Backups im Snapshot-Modus und Bare-Metal-Recoveries
Ein Engineer erzählte sogar, er habe mit DreamFactory schnell eine Integrationsschicht gebaut, die leichtgewichtige REST-Endpunkte für Kontingente und Inventar bereitstellt. Das dauerte ein Wochenende statt eines Budgetzyklus.
Teamübergreifend ist die Stimmung dieselbe: Proxmox liefert die Bausteine, und wie Sie sie zusammenstecken, bleibt Ihnen überlassen.
Und dann ist da noch Oracle
Jeder Engineer mit Oracle-Workloads rät dasselbe: isolieren. Oracle gehört auf einen dedizierten Cluster, ohne Migration, ohne vMotion, ohne Eingriffe in CPU-Grenzen und ohne Überraschungen für den Auditor. Am Ende steht eine ruhige kleine Insel mit dokumentierten Grenzen.
Der eigentliche Schock: Wie ereignislos alles wird, sobald das Design stimmt
Die lauteste Botschaft der Engineers, die den Sprung gewagt haben, klingt überraschend langweilig. Sobald der Storage stimmt, das Netzwerk sauber ist, NUMA verstanden wird und die Migrationspraxis sitzt, wird Proxmox ruhig. Die Plattform ist weder angeberisch noch auffällig, sie ist einfach stabil.
Updates kommen an, Backups laufen, Ceph heilt sich selbst, und VMs tun, was VMs eben tun. Die Plattform verschwindet in den Hintergrund, so angenehm, wie es ESXi einst tat, bevor die Rechnung kam.
Die eigentliche Arbeit steckt weniger in den Migrationsskripten oder VM-Importen als im Ablegen alter Annahmen. VMware hat geprägt, wie sich Virtualisierung für viele anfühlen soll, und Proxmox verlangt, ein bisschen anders zu denken. Die Teams, die sich darauf einlassen, fragen sich meist, warum sie nicht früher gewechselt sind.