

AWS East-1 wird dunkel: Warum die beliebteste Cloud-Region zu ihrer größten Schwachstelle wurde
Am 20. Oktober fiel die AWS-Region US-EAST-1 aus, und Ingenieure auf der ganzen Welt bekamen früh morgens die Art von Weckruf, die niemand will. Ihre Monitoring-Dashboards wurden flach, Alarme explodierten in Slack (oder auch nicht, weil Slack auch down war), und das AWS Health Dashboard lieferte das immer vage "operational issue" für die US-EAST-1-Region. Zu diesem Zeitpunkt war der Schaden bereits angerichtet. Dienste, die riesige Teile des modernen Webs stützen, waren hinüber, und stundenlang versuchten Teams herauszufinden, was zur Hölle passiert war. Der Übeltäter war am Ende wieder einmal DNS, und die Ironie daran ist schmerzhaft. Die gesamte AWS-Infrastruktur soll auf hoher Verfügbarkeit basieren, verteilt über mehrere Availability Zones (AZs) innerhalb von Regionen, und wird als resilient by design vermarktet. Als jedoch US-EAST-1, Amazons größte und älteste Region, so hart abstürzte, enthüllte es etwas, das die Tech-Community seit Jahren flüstert: Von US-EAST-1 hängt weit mehr ab als von jeder anderen Region.
Wie ein DNS-Eintrag die Party ruinierte
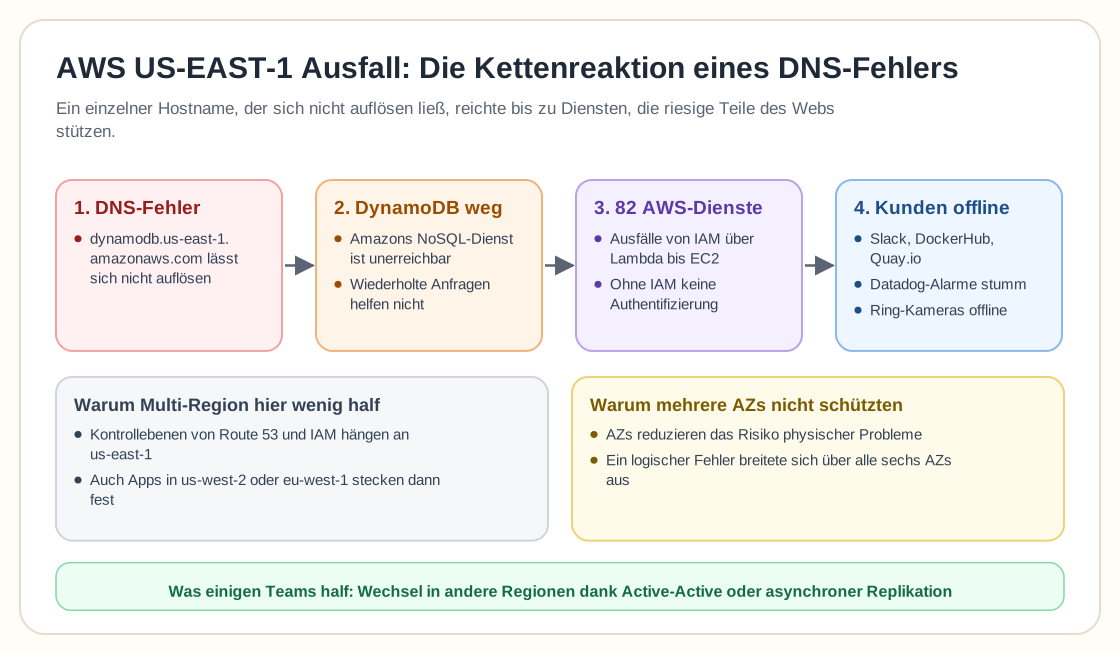
Im Zentrum des Chaos stand DynamoDB, Amazons serverloses NoSQL-Arbeitstier, das für eine Weile unerreichbar wurde. Der Grund: Die DNS-Auflösung für dynamodb.us-east-1.amazonaws.com schlug fehl. Dieser einzelne Ausfallpunkt hatte einen Dominoeffekt und löste laut Community-Updates Ausfälle in mindestens 82 AWS-Diensten aus, von IAM über Lambda bis EC2.
Das war ein ausgewachsener Architektur-Bauchschlag. Weil IAM (Identity and Access Management) gestört war, konnten andere Dienste sich nicht mehr authentifizieren, nichts orchestrieren und nicht mehr miteinander kommunizieren.
Ohne DNS hörten Dienste, die auf dynamische Endpunkt-Entdeckung angewiesen sind, einfach auf. Wenn Sie einen Hostnamen nicht auflösen konnten, konnten Sie nichts tun. Und nein, das Wiederholen Ihrer Anfragen half nicht.
East-1 ist nicht optional, und das ist das Problem
AWS bewirbt Multi-Region-Redundanz als Goldstandard. Aber ironischerweise sind viele globale Dienste eng mit der US-EAST-1-Region gekoppelt, einschließlich der Kontrollebenen für Route 53 (ihren eigenen DNS-Dienst) und IAM. Das bedeutet: Selbst wenn Ihre Anwendung us-west-2, eu-west-1 oder ap-southeast-2 umfasst, stecken Sie fest, sobald das Gehirn der Operation in us-east-1 lebt.
Nutzer in Dev-Communities wiesen darauf schnell hin, etwa so:
"AWS: für maximale Resilienz benötigen Sie Redundanz über mehrere Regionen. Auch AWS: viele unserer Dienste haben eine Kontrollebene, die einen Single Point of Failure in us-east-1 hat"
Ein anderer scherzte:
"us-east-1 ist seit Jahren kaputt. Ich schätze, sie haben es einfach zugegeben und abgeschaltet."
Humor beiseite, die Abhängigkeit von dieser einen Region ist ein systemisches Problem. Einige spekulieren sogar, dass AWS Entwickler subtil dazu anregt, groß auf eine einzelne Region zu setzen, indem es dort die niedrigsten Preise und die schnellste Latenz anbietet, auch wenn sie es nicht sollten.
Alle AZs der Welt werden Sie nicht vor schlechtem Design retten
Availability Zones sollten diese Art von Sache verhindern. Jede AZ hat ihre eigene Stromversorgung, ihre eigenen Kühlsysteme und ihre eigene Netzwerk-Infrastruktur. Die Idee ist, dass die anderen die Last tragen, selbst wenn ein Meteor ein Rechenzentrum trifft. Aber dieses Modell funktioniert nur, wenn Probleme physisch sind.
Wenn das Problem logisch ist, etwa ein verpatztes DNS-Update oder eine fehlerhafte Bereitstellung, spielt es keine Rolle, wie viele AZs Sie herumgestreut haben. Wenn der Ausfallpunkt in der Software liegt und sich über die gesamte Region ausbreitet, gehen Sie unter, wie ein Kommentator es auf den Punkt brachte:
"AZs reduzieren das Risiko physischer Probleme. Sie sind nicht narrensicher gegen Softwareprobleme, die in der gesamten Region bereitgestellt werden."
Genau das ist hier passiert. Ob durch Bereitstellungsautomatisierung, Verbreitung von Fehlkonfigurationen oder einen Abhängigkeitsfehler, das Problem traf nicht nur eine AZ. Es verbreitete sich wie ein Lauffeuer über alle sechs.
Der Fall von Slack, DockerHub, Ring und Freunden
Das Gemetzel beschränkte sich nicht auf AWS-Kunden, die Nischen-Apps betreiben. Betroffene Hauptdienste:
| Dienst | Auswirkung |
|---|---|
| Slack | Kommunikation ausgefallen |
| DockerHub | Container-Registry nicht verfügbar |
| Quay.io | Image-Pulls fehlgeschlagen |
| Datadog | Monitoring-Alarme stumm |
| Ring | Sicherheitskameras offline |
Benutzer konnten sich nicht in die AWS-Konsole einloggen, Sicherheitskamera-Feeds überprüfen oder sogar Monitoring-Alarme erhalten. Viele erfuhren nur von ihren eigenen Ausfällen, weil Reddit und X (ehemals Twitter) noch funktionierten.
Einen besonders meta Moment lieferten Benutzer, die scherzten: "Es ist immer DNS", gefolgt von "Auf keinen Fall ist es wieder DNS." Und dann: "Es war DNS." Der Kommentarbereich las sich wie ein Meme-Friedhof, gefüllt mit Unglauben und Galgenhumor. Ein paar Leute scherzten über verschütteten heißen Kaffee im Serverraum oder verfluchte Infrastruktur. Aber hinter dem Lachen lag ein tieferes Problem: ein wachsendes Misstrauen in die Resilienz angeblich redundanter Cloud-Systeme.
Was hätte getan werden sollen und noch getan werden kann
AWS hat keine SLAs gebrochen, ihre rechtlichen Garantien berücksichtigen diese Art von Sachen. Aber Vertrauen ist eine andere Währung, und sie wird dünn. Was also jetzt?
Einige Teams haben es richtig gemacht. Eine Handvoll Ingenieure berichtete stolz, dass ihre Systeme sauber zu us-east-2 oder anderen Regionen übergingen, dank Active-Active-Setups oder zumindest asynchroner Replikation. DynamoDBs Global Tables unterstützen, wenn richtig konfiguriert, Multi-Region-Schreibvorgänge, ein seltener Lichtblick im Chaos. Aber es erfordert Mühe, Architekturplanung und, yep, Geld.
Und da ist der Haken. Einer der am meisten hochgewählten Kommentare fasste es zusammen:
"Die Kosten, eine App resilient gegen regionale Ausfälle zu machen, sind nicht immer geschäftlich sinnvoll. Die Regionen und Dienste sind unglaublich stabil, und eine große Anzahl von Kunden-Apps kann legitim kurz die Verfügbarkeit verlieren, ohne dass Schaden entsteht."
Mit anderen Worten: Risikotoleranz ist eine Geschäftsentscheidung. Sie können für regionale Redundanz bauen. Aber für die meisten ist es eine Frage der Kompromisse.
Ein größeres Problem in Verkleidung
Dieser Ausfall war mehr als ein Zufall. Er ist eine Reflexion der Cloud-Architektur im Maßstab, mit versteckten Abhängigkeiten, undurchsichtigen Kontrollebenen und Designentscheidungen, die sich über ein Jahrzehnt stapeln, bis sie zu unsichtbaren Engpässen werden.
Er ist auch eine Erinnerung daran, dass die Grundlagen immer noch wichtig sind, egal wie weit wir mit Automatisierung, maschinellem Lernen und cloud-nativen Best Practices gehen. DNS ist uralte Technik und gleichzeitig essentiell. Wenn es ausfällt, bricht alles zusammen.
Amazon wird das aufräumen, Dienste sind bereits wieder online. Eine formelle Postmortem wird folgen, wahrscheinlich dicht mit technischem Jargon und schwer auf gelernten Lektionen.
Aber wenn us-east-1 das nächste Mal wackelt, und das wird es, fragen Sie sich: Was haben Sie beim letzten Mal gelernt? Die beliebteste Cloud-Region verschwindet jedenfalls nicht, Ihr Single Point of Failure sollte es aber vielleicht, nur vielleicht, tun.