

Proxmox-HA-Storage: Ceph vs. ZFS-Replikation vs. NAS-Failover im Vergleich
Wenn Sie schon einmal vor einem Rack voller Server standen und sich gefragt haben, ob Sie Ihr Storage-Setup komplett falsch angehen, sind Sie nicht allein. Hochverfügbarkeit (HA) in Proxmox ist ein Traum, dem viele nachjagen, und wie Sie dorthin kommen, hängt stark davon ab, auf welche Storage-Strategie Sie setzen: Ceph, ZFS oder klassisches NAS. Jede bringt ihre Vorzüge, Fallstricke und regelrechten Missverständnisse mit sich. Die hitzigen, aufschlussreichen (und manchmal urkomischen) Nutzergeschichten aus dem Netz zeigen jedenfalls, dass viele Teams noch immer nach der richtigen Richtung suchen.
10.000 Workloads migrieren: Können Proxmox & Ceph VMware wirklich ersetzen?
Schneiden wir uns also durch Buzzwords und Marketing-Geschwafel und schauen uns an, was wirklich funktioniert, was nicht, und welche dieser Optionen für Ihr Proxmox-Setup am meisten Sinn ergibt. (Wenn Sie nur den allgemeinen Vergleich zwischen Ceph und ZFS ohne den HA/NAS-Blickwinkel wollen, lesen Sie unseren ausführlicheren Ceph-vs-ZFS-Vergleich.)
Der Ceph-Hype und wann er sich wirklich lohnt
Ceph hat sich zum inoffiziellen König des verteilten Storage entwickelt, besonders in hyperkonvergenten Umgebungen wie Proxmox. Richtig aufgesetzt ist es schnell, selbstheilend und unglaublich robust. Die Integration mit Proxmox ist nahtlos: Sie können OSDs hochfahren, den Gesundheitszustand überwachen und Pools direkt über die GUI verwalten. Für viele „funktioniert es einfach."
Sobald Sie aber versuchen, ein Ceph-Setup aus einem einzigen monströsen „Storage-Node" und ein paar Compute-Boxen mit winzigen SSDs zusammenzuschustern, fällt alles auseinander.
Ein Nutzer traf es auf den Punkt: Das Chaos verursacht die Art, wie Leute Ceph aufsetzen, und nicht Ceph selbst. Wenn Sie 80 % Ihres Storage auf einem Node zentralisieren, bauen Sie ein SAN mit ein paar zusätzlichen Schritten, und Ceph wird Sie nicht vor sich selbst retten.
Moderne Ceph-Setups brauchen auch kein Dutzend Nodes. Mehrere Admins berichteten, dass ihre Drei-Node-Ceph-Cluster großartig liefen, mit voller Redundanz, guter Performance und ohne Merkwürdigkeiten. Voraussetzung war, dass sie keine Laufwerkstypen mischten, RAID-Controller außen vor ließen und für ordentliches Networking sorgten (denken Sie an 25/40/100GbE statt an Ihren verstaubten Büro-Switch).
Ein Tipp für den reibungslosen Betrieb: Verwenden Sie Enterprise-SSDs, meiden Sie SMR-Laufwerke wie die Pest und stellen Sie sicher, dass Ihre HBAs im IT-Modus laufen.
ZFS, das „gut genug"-Arbeitstier, das einfach nicht aufgibt
ZFS ist nicht sexy und hat nicht den Marketing-Schub von Ceph. Geliebt wird es trotzdem, und zwar aus gutem Grund: Es funktioniert, und zwar gut.
In kleineren Proxmox-Deployments bringt Sie ZFS mit Replikation überraschend nah an das heran, was die meisten als „HA" bezeichnen würden. Echte Hochverfügbarkeit ist das nicht ganz, denn bei einem Node-Ausfall haben Sie vielleicht ein paar Minuten Downtime. Für viele Umgebungen ist das aber ein akzeptabler Kompromiss.
Der große Vorteil ist die Einfachheit. ZFS-Replikation ist kinderleicht einzurichten, sogar über Nodes hinweg. Sie können das Dataset einer VM auf zwei oder drei andere Boxen replizieren lassen, und stirbt eine, booten Sie einfach von der Replik. Das geht nicht sofort, ist aber zuverlässig.
Ein Admin sagte es unverblümt: „Viele Leute übertreiben ihre Uptime-Anforderungen gewaltig und überengineeren deshalb ihr Cluster-Design. ZFS ist für viele Fälle einfach perfekt."
Dazu kommt die Performance. ZFS ist stark bei lokalem Disk-IO, besonders mit schnellen SSDs und viel RAM, und es bringt granulares Snapshotting, Kompression und Checksumming gleich mit.
Allerdings skaliert ZFS nicht wie Ceph. Sobald Sie über 4 bis 5 Nodes hinauswachsen, wird die Verwaltung der Replikation mühsam, und echtes HA mit Fencing und Failover lässt sich manuell nur noch schwer pflegen.
NAS: Die alte Garde hält sich weiterhin
Und dann gibt es noch NAS, den traditionellen Weg: ein paar Head-Nodes mit einem gemeinsamen Disk-Shelf, das NFS oder iSCSI an Ihren Proxmox-Cluster exportiert. Das funktioniert, ist vertraut und für bestimmte Setups in vielerlei Hinsicht weiterhin eine solide Wahl.
Mit einem soliden HA-fähigen NAS (TrueNAS, XigmaNAS, Synology usw.) und der richtigen Dual-Head-Redundanz erreichen Sie echte Hochverfügbarkeit auf der Storage-Ebene. Der Trick besteht darin, es richtig zu machen.
Der Haken: Open-Source-Optionen für echtes HA-NAS sind begrenzt. TrueNAS zum Beispiel bietet Hochverfügbarkeit nur auf seiner proprietären Hardware. Andere wie XigmaNAS unterstützen zwar CARP/HAST-Setups, aber Plug-and-Play ist das nicht. Sie werden sich mit FreeBSD-Eigenheiten und manuell angepassten Skripten die Hände schmutzig machen.
Selbst wenn Sie es hinbekommen, bleiben Ihre Proxmox-Nodes an externen Storage gebunden. Damit verlieren Sie viele Vorteile der Hyperkonvergenz, etwa die vereinfachte Skalierung und die Fehlertoleranz.
Auch die Performance kann Glückssache sein. Manche Setups mit schnellen SSDs und Hochgeschwindigkeitsverbindungen schlagen sich gut, aber in einem richtig verteilten Setup hat Ceph viele kommerzielle NAS-Appliances beim Durchsatz und bei der Ausfallsicherheit übertroffen.
Der Elefant im Serverraum: falsche Erwartungen
Was sich durch all diese Diskussionen zieht, ist falsch konfigurierte Hardware.
Es ist fast schon ein Klischee: Jemand kauft acht Compute-Nodes mit winzigen SSDs und ein einziges „Storage-Monster" mit 200TB und wundert sich dann, warum sich das Ceph-Setup merkwürdig verhält. Oder jemand verpulvert 700.000 Dollar für SQL-Lizenzen für eine Box mit 96 untertakteten Kernen, weil „mehr ist besser", ohne zu merken, dass die eigenen Workloads gar nicht so skalieren.
Ein DBA formulierte es bissig: „HA = Hirn Aus." Ganz falsch liegt er damit nicht.
Die beste Storage-Strategie in Proxmox läuft oft darauf hinaus, für die Architektur zu bauen, die Sie tatsächlich nutzen. Zwängen Sie Ceph nicht in ein zentralisiertes Storage-Modell, erwarten Sie von ZFS nicht dasselbe wie von Ceph, und gehen Sie nicht davon aus, dass NAS wie verteilter Storage skaliert, nur weil die GUI eine HA-Checkbox hat.
Also, was sollten Sie verwenden?
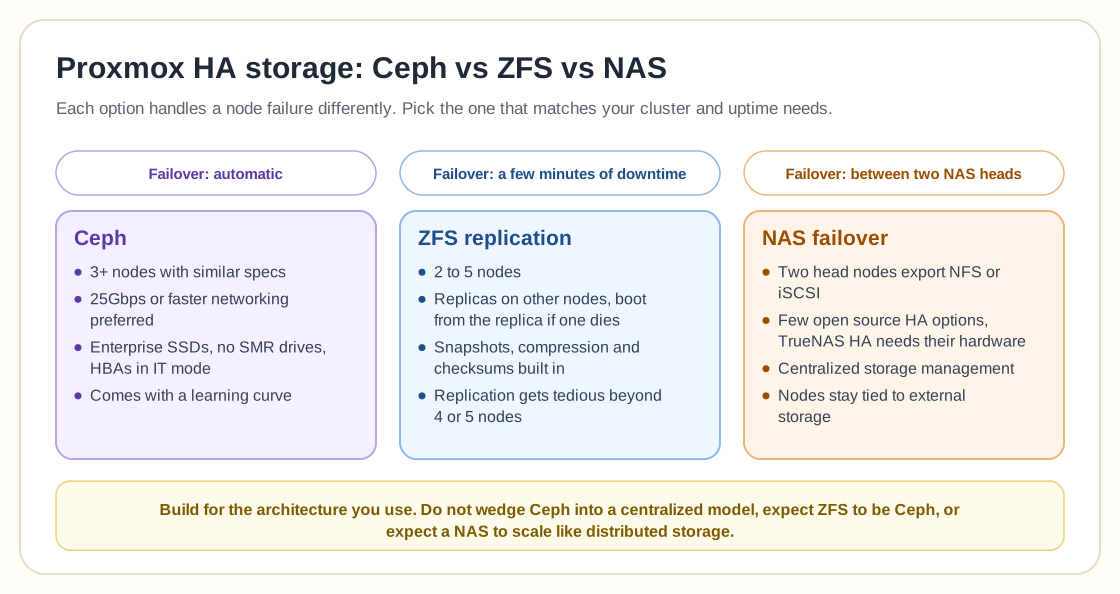
Nach Szenario aufgeschlüsselt:
Nutzen Sie Ceph, wenn…
- Sie 3+ Nodes mit ähnlichen Spezifikationen betreiben
- Sie echte Hochverfügbarkeit und automatisches Failover wollen
- Sie Hochgeschwindigkeitsnetzwerk verkabeln können (25 Gbit/s oder besser bevorzugt)
- Sie mit einer Lernkurve klarkommen (oder bereits mit Proxmox und Linux vertraut sind)
Nutzen Sie ZFS, wenn…
- Sie einen kleineren Cluster haben (2 bis 5 Nodes)
- Sie kurze Downtime zugunsten von Einfachheit in Kauf nehmen können
- Sie solide Performance und eingebautes Snapshotting wollen
- Sie einen unkomplizierten Weg suchen, um Replikation schnell zum Laufen zu bringen
Nutzen Sie NAS, wenn…
- Sie bereits zuverlässige Dual-Head-NAS-Hardware haben
- es Ihnen nichts ausmacht, sich auf externen Storage zu verlassen
- Sie zentralisiertes Storage-Management bevorzugen
- Sie keine Cloud-Skalierungsflexibilität brauchen
Fazit
Bei Hochverfügbarkeit müssen Sie das Tool wählen, das zu Ihrem Setup passt. Ceph, ZFS und NAS haben jeweils ernstzunehmende Stärken, können aber genauso leicht nach hinten losgehen, wenn Sie sie unüberlegt einsetzen.
Überengineeren Sie Ihren Cluster nicht, und kopieren Sie nicht die Architektur eines anderen, ohne zu verstehen, warum sie dort funktioniert. Nehmen Sie sich die Zeit, Ihre tatsächlichen Bedürfnisse bei Uptime, Budget, Kenntnisstand und Umfang zu bewerten, und bauen Sie dann ein System, das hochverfügbar und zugleich wartbar ist.
Am Ende ist das beste HA-Setup nämlich das, das Sie nicht um 3 Uhr morgens wegen kaputtem Quorum und einem blinkenden Konsolen-Cursor aufweckt.